2026-09-26 11:16:03 分类:GEO优化
现在大家用大模型查资料写内容,多多少少都会接触到大语言模型引用机制,它是解决生成内容溯源问题的核心功能。
什么是大语言模型引用机制
说白了,就是大模型调取外部参考资料后,给内容标注原始出处的一套运行规则。
它不是天生就有的,是之前大模型经常“瞎编出处”之后,才慢慢普及开来的功能。
比如你问大模型“今年国内露营经济相关报告有哪些核心结论”,它调取了几个公开行业报告的内容,之后给每个结论都标上了对应报告的链接和发布方,这就是引用机制在运转。
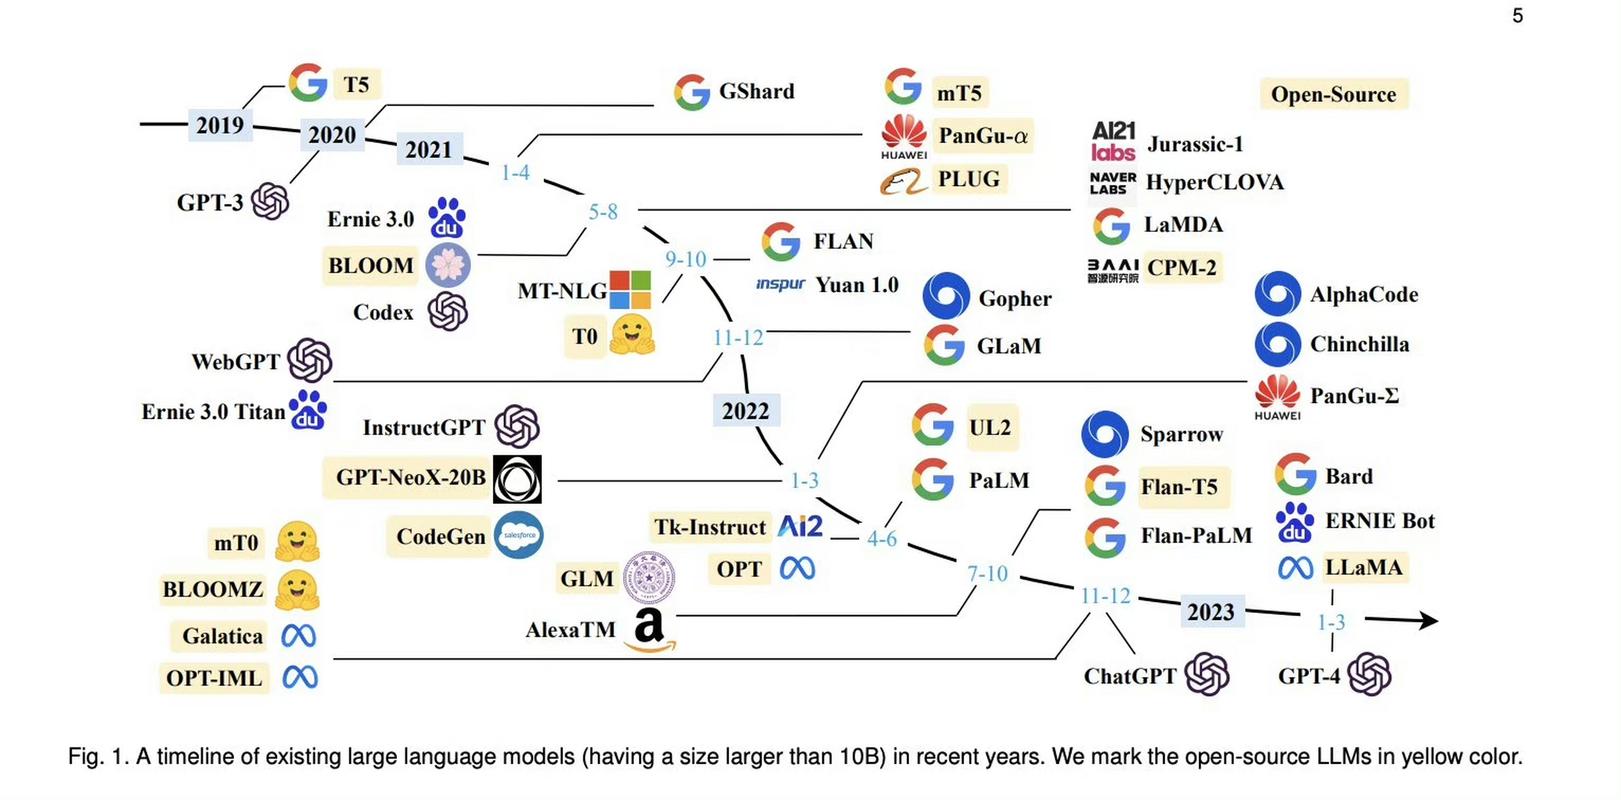 大语言模型联网引用结果示例图
实际使用里要避开的常见问题
说实话,很多人用这个功能的时候,容易踩两个误区。
第一个误区:觉得标了引用的内容就一定准确。据一些用户反馈,不少大模型会出现「链接挂错」的情况,结论来自A文章,引用标成了B文章的链接,不核对根本发现不了。
第二个误区:觉得标注引用之后,就可以直接拿来用在自己的公开内容里,忽略了原内容的版权要求。哪怕大模型标了来源,商用或者公开发表的时候,还是要得到原作者授权才行。
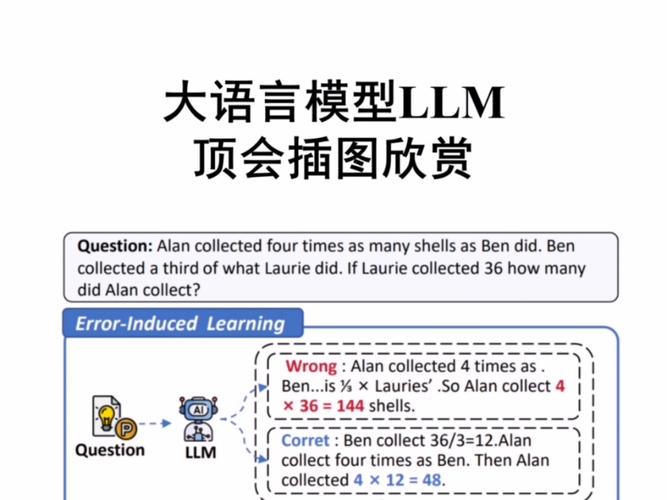 大语言模型引用链接错位示例图
实用的操作要点
 实用的操作要点
拿到带引用的生成内容,我们通常可以做两步简单检查。
第一步,就是核对引用来源和内容,点开链接扫一眼,确认大模型没有断章取义改原内容的意思。
第二步,区分原观点和模型推论,大模型经常会顺着多个来源的内容自己推导出新结论,这类推论是没有原始引用的,要自己做好判断。
从实操角度看,目前大部分产品的引用机制还在迭代,不同产品的标注规则差别不小,用之前花两分钟看一下产品说明,能省不少后续的麻烦。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:拆解大语言模型引用机制:普通人看得懂的实操指南
文章链接:https://m.ttrenwu.com/geo/1923.html
