现在我们找信息,早就不用老老实实敲整句关键词了,拍个图、录两句音就能出结果,这背后就是多模态内容检索在起作用。
多模态内容检索通常用在哪些场景
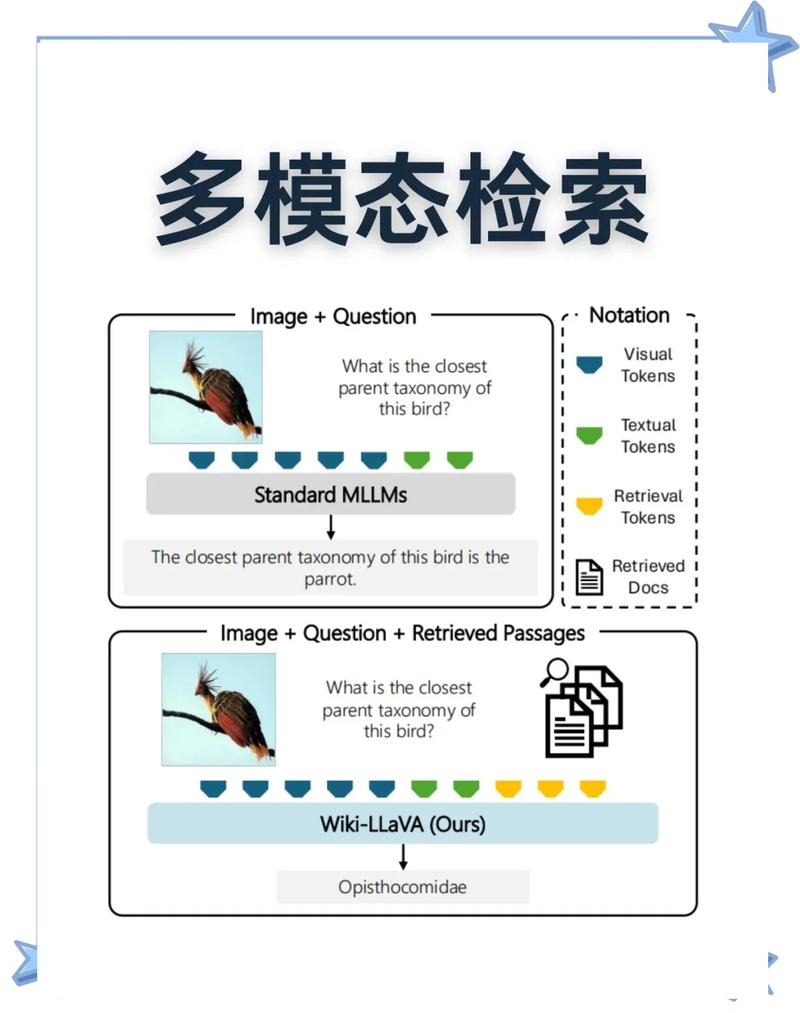
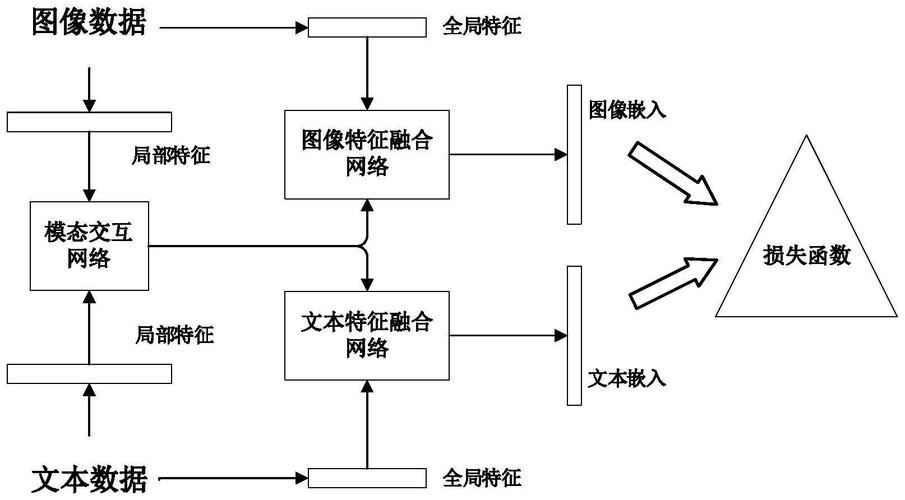
多模态内容检索,核心就是输入信息类型不局限于文字,系统可以同时处理图像、音频、视频这些不同格式的内容,从中提取特征再匹配检索结果。
举个例子,出门旅游看到一棵好看的树叫不出名字,掏出手机拍一张直接上传搜索,几秒钟就能出来对应物种信息,这就是较为常见的多模态检索应用。
还有,哼旋律找歌,也是一样的道理,把你哼的音频特征和曲库的音频特征匹配,就能找到目标歌曲。
使用多模态内容检索要留意哪些问题
说实话,很多人对它的期待有点超出当前的能力范围,踩过不少小坑。
第一个坑,输入信息的质量直接影响结果。要是你拍的图晃到模糊,或者录音周围全是杂音,系统提取不到准确特征,结果自然不对。据一些用户反馈,超过六成的“检索不准”吐槽,都源于输入质量太差。
第二个坑,不要默认结果一定准确。多模态检索做的是特征匹配,不是内容本质的判断,比如你拍了一个外形高度相似的仿款包,很容易出来正品的信息,需要自己交叉验证。
当前行业的发展方向
有意思的是,现在个人相册搜索也开始用上多模态检索了,不用你手动给照片打标签,只要说一句“找一下我拍的小猫”,系统就能自动把所有带猫的照片找出来,比原来翻半天方便太多。
不过话说回来,目前对小众内容的支持还不够好,比如你拍了一个私人定制的手作,大概率搜不到对应信息,这个得有预期。
从实操角度看,普通用户用它解决生活里的常见问题,已经足够好用。
您在实际使用多模态内容检索的时候,还遇到过哪些有意思或者困扰的情况?欢迎结合具体场景继续探讨。
