2026-09-17 14:58:42 分类:GEO优化
我们用大语言模型查资料写东西的时候,最犯愁的就是不知道内容来自哪儿靠不靠谱,大语言模型引用机制就是帮我们解决这个问题的。
基础认知:它到底帮我们做什么
说白了,就是给大语言模型生成的内容标注来源出处的一套规则。
它不是什么玄乎的新东西。
比如你问它2024年新能源汽车的销量数据,开启引用机制的模型会告诉你具体数字,同时标出这个数据来自哪份行业报告,具体在哪个页面。如果你写综述找参考,直接就能顺着去找原文核对,省了大把搜资料的时间。
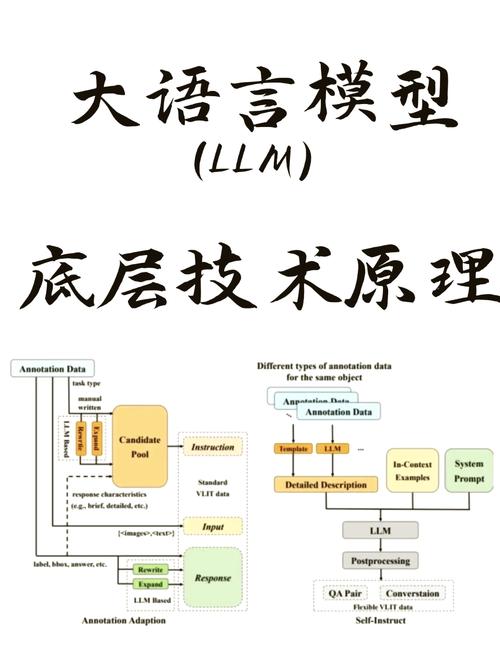 大语言模型引用机制标注结果示例
日常使用要避开的常见误区
很多人觉得只要开了引用,内容就一定没问题,其实不是。
说实话,现在很多工具的引用机制做的很粗糙。
据一些用户反馈,不少工具只是把和问题相关的页面堆在结尾,根本不对应具体生成内容,你找半天都找不到出处在哪里。比如你问某份公开报告的核心观点,它给你列了五篇相关文章,点进去每篇都没你要那段话。这就是典型的凑数引用。
还有个误区,就是拿到带引用的内容直接用,完全忽略了版权问题,哪怕来源标注对了,商用或者公开发表也要征得原作者同意,这点很容易忘。
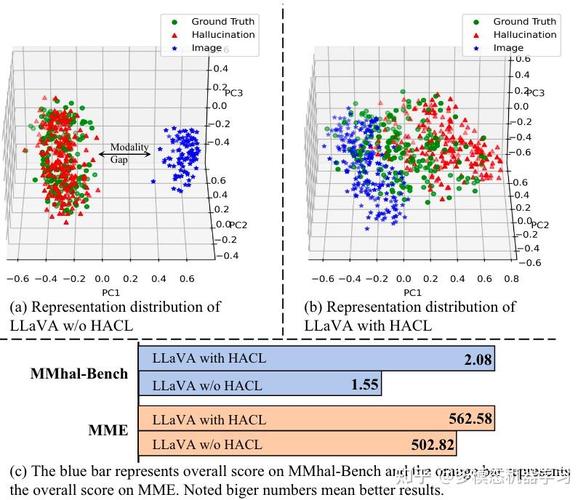 大语言模型正确与错误引用对比图
不同实现思路的适用场景
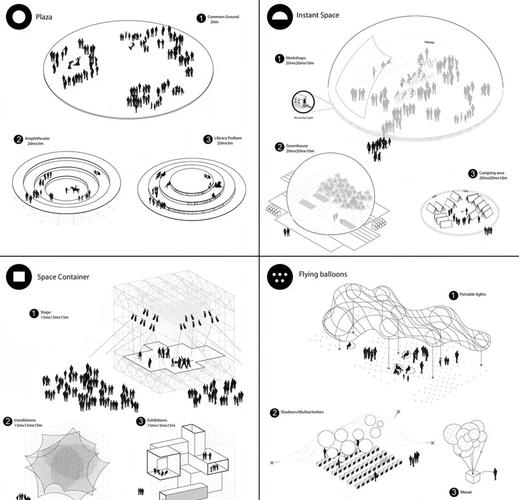 不同实现思路的适用场景
有意思的是,现在行业里做引用机制的思路主要分两种,差别还挺大。
一种是先搜索后生成,大语言模型先搜出相关公开内容,再基于这些内容组织答案,引用和内容一一对应,准确率较高,适合查学术资料、核实数据的时候用。
另一种是先生成后匹配来源,大语言模型先按照自己的逻辑生成流畅答案,再去找和内容匹配的来源挂上去,这种生成的内容可读性更好,但容易出现文不对引的问题,日常找参考思路的时候用还行。
从实操角度看,没有哪种思路完全碾压另一种,主要看你用在什么地方。
您在实际使用中还遇到过哪些奇怪的引用问题?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:大语言模型引用机制:实用科普与避坑指南
文章链接:https://m.ttrenwu.com/geo/1481.html
