基础认知:两者到底是怎么配合的
说白了,实体识别是知识图谱的“眼睛”。它要从一段杂乱的文本里,把有具体意义的实体给挖出来。比如你发一条动态“下个月带猫去北京宠物医院打疫苗”,实体识别会帮你把“猫”“北京宠物医院”“疫苗”这些实体给拆分出来。
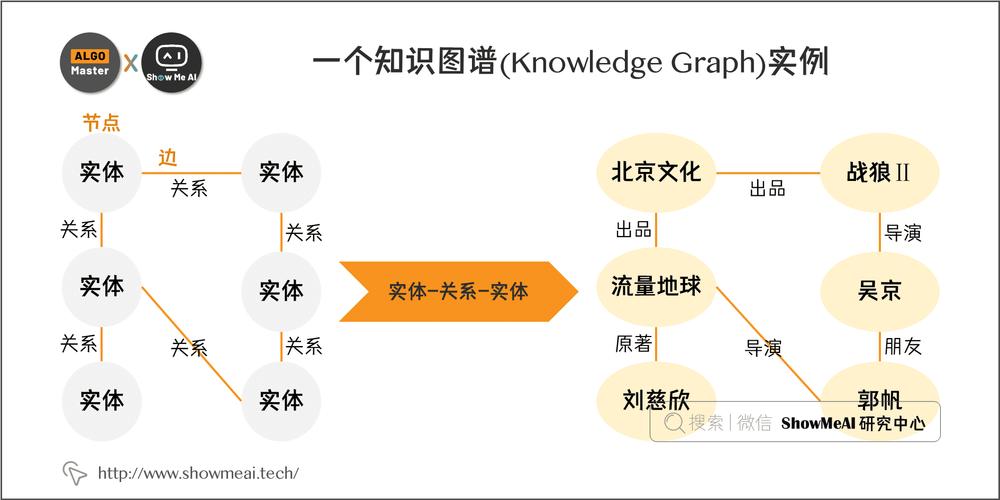
知识图谱则是把这些实体按关系串起来的“网”。它会存储“猫是宠物”“北京宠物医院位于北京”“疫苗用来预防疾病”这类关联,方便后续快速调用匹配。
落地时容易踩的几个常见误区
很多新手刚做的时候,会默认实体识别就是提取关键词,其实不对。
最大的问题是歧义。比如同样是“小米”,在“我买了小米手机”里是品牌,在“我煮了小米粥”里是粮食,要是识别错了,整个知识图谱的关联就错了。
据一些用户反馈,做垂直领域知识图谱的时候,九成以上的初期错误都来自实体识别的歧义或边界错误。比如把“四川省人民医院”拆成“四川”“省”“人民医院”三个独立实体,完全破坏了原本的语义。
普通开发者的入门小建议
说实话,现在不用从零训练实体识别模型。公开的预训练模型已经能覆盖大部分通用场景的需求。
要是做垂直领域项目,通常只需要标注几百条领域内的样本,给预训练模型做微调就够用了。需要留意的是,不要一开始就追求覆盖所有实体类型,先抓核心需求就好。比如做餐饮知识图谱,先搞定店名、菜品名、地址三类核心,后续再慢慢补充其他类型。
从实操角度看,小项目优先选成熟的开源工具,能省掉大把重复造轮子的时间。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
