我们平时刷电商推荐、搜景点攻略,背后都有知识图谱与实体识别在默默工作。
什么是知识图谱与实体识别?日常都用在哪?
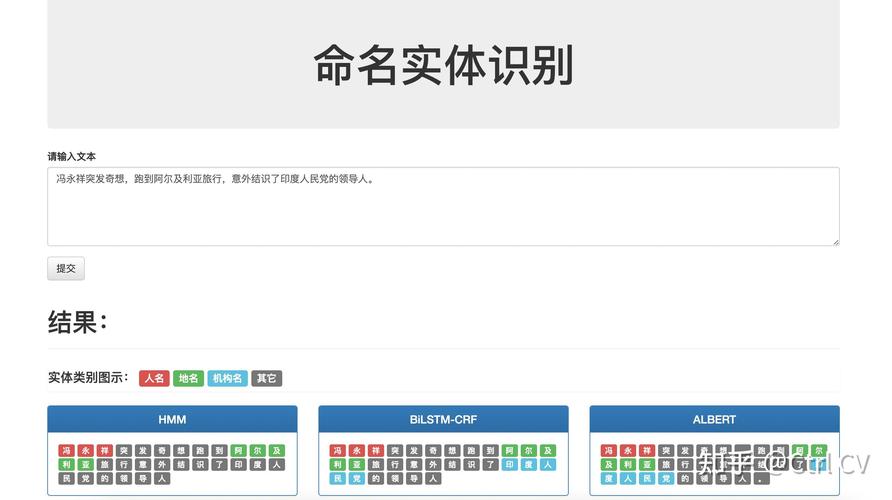
实体识别本质上就是从杂乱的文本、图像信息里,把有明确意义的独立实体找出来,还要给它贴上分类标签。
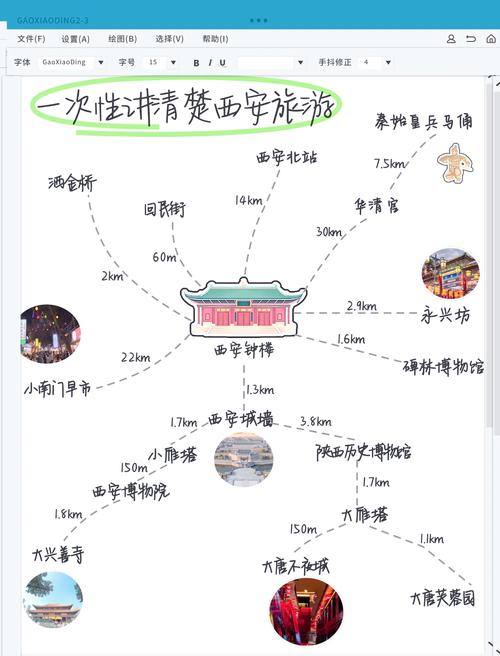
举个例子,你在旅游评论里写“上周带我家狗去杭州西湖边的太子湾公园玩了”,实体识别会自动识别出「杭州」「西湖」「太子湾公园」这些地点实体,还有「狗」这种生物实体。
知识图谱呢,就是把所有识别出来的实体,按它们之间的真实关系连起来,做成一张类似人脑认知的关系网。比如“太子湾公园 位于 杭州西湖景区”,“西湖 毗邻 灵隐寺”这种关系都会被梳理清楚。
实操里最容易踩的几个误区
说实话,很多刚接触项目的朋友都容易踩坑。从实操角度看,最常见的两个问题分享给大家。
第一个是贪多,想把所有能识别的实体都抠出来。其实完全没必要,只需要提取和业务目标相关的实体就够了。比如做旅游知识图谱,你不需要专门识别文本里提到的化妆品品牌实体,徒增算力消耗。
第二个是标注标准混乱。据一些用户反馈,团队做实体标注的时候,没提前统一规则,有人把“西湖景区”算一个实体,有人拆成“西湖”和“景区”两个,最后训练出来的模型准确率掉十几个点,想调都难。
需要留意的是,实体和实体关系都是动态更新的,比如新开发的商圈、新改名的景点,原来的模型很难识别,通常每几个月更新一次训练数据集就可以,这个节奏也看你业务的变化速度。
和普通关键词提取有什么不一样?
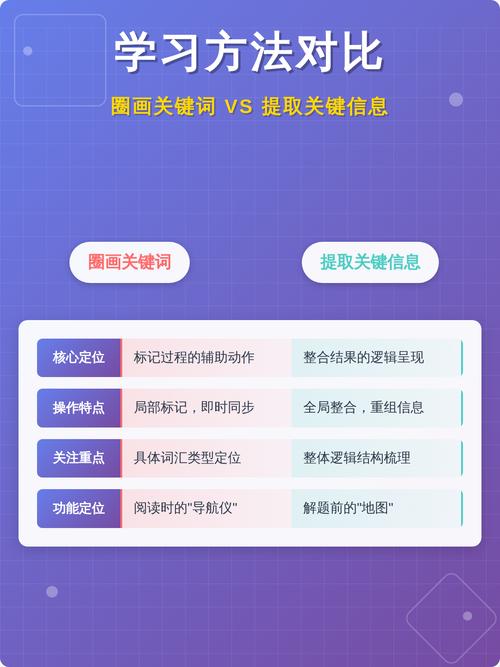
有意思的是很多新手会把这两个概念搞混。
简单说,关键词提取只要把文本里的核心词抽出来就行,不需要管它是什么类别,也不需要管它和其他词的关系。但实体识别不一样,抽出来还得分类,比如告诉你这是“景点”还是“酒店”,为后续知识图谱搭建做准备。
不过话说回来,现在很多中小项目,也会先用关键词提取做初筛,把没用的内容过滤掉再做实体识别,能省不少成本。
您在实际使用知识图谱与实体识别的过程中,还遇到过哪些问题?欢迎结合具体场景继续探讨。
