先搞懂:结构化数据标注到底用在哪儿
简单说,它的核心是给数据按照固定规则划分属性、打上对应标签,最终产出能直接被机器读取调用的规整数据。
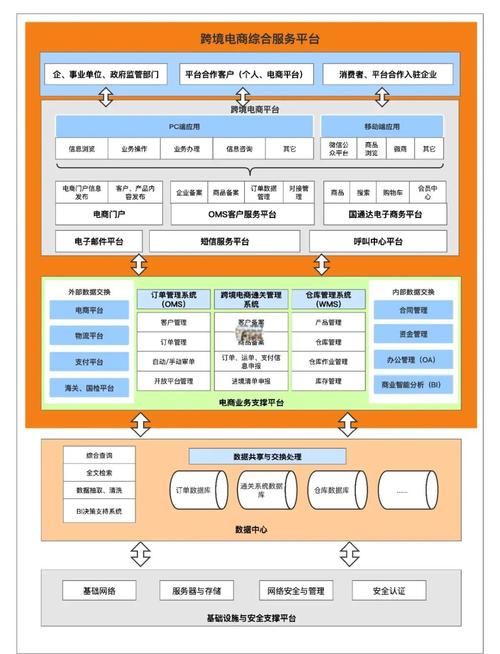
比如在电商平台梳理商品库的情况下,你需要把每款商品的品牌、价格、尺码、材质分别提取出来对应到固定字段,这就是典型的结构化数据标注。
自动驾驶训练里,把路面上每个交通标识的类别、坐标、尺寸按要求整理进对应数据表,也是它的常用场景。
实操里最容易踩的几个坑
标注规则的一致性是很多新手容易忽略的点。据一些用户反馈,中小AI团队初期没定清楚统一规则,返工率能超过三成。
比如同样是标注电商商品的“价格”,有人把折扣价放进原价字段,有人统一放进活动价字段,最后混在一起的数据集根本没法用。
还有一个常见误区是过度标注。本来项目只需要提取商品的核心参数,非要把包装颜色、快递包邮信息也都额外标注,既浪费人力,又给数据引入多余噪声。说实话,这种无效出力的情况我见得真不少。
需要留意的是,标注完成后抽10%到20%的样本做交叉校验就足够,没必要全量检查。
它和非结构化标注有啥不一样
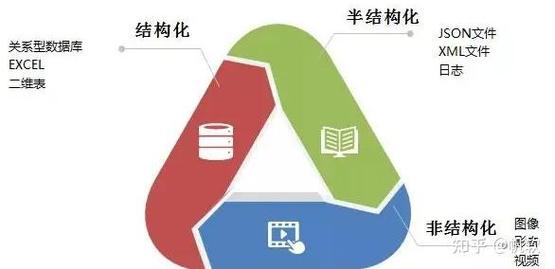
有意思的是,很多刚接触数据标注的人都会把这两个概念搞混。
非结构化标注通常是给没有固定格式的内容打整体标签,比如给一张旅游照片整体标上“海边日落”就完成了。
而结构化标注要求把内容拆解成一个个明确的属性字段,同样是处理简历,非结构化标注只需要标“这是一份互联网行业简历”,结构化标注要把姓名、工作年限、项目经历分别抠出来对应到预设字段。
从实操角度看,结构化标注对规则理解的要求更高,产出的数据机器处理效率也更高,现在大模型的微调训练,对这类数据的需求一直在涨。
您在实际接触数据标注的过程中,还遇到过哪些和结构化标注相关的问题?欢迎结合具体场景继续探讨。
