2026-09-25 20:33:50 分类:GEO优化
结构化数据标注是给AI训练整理标准数据的核心环节,市面上大到自动驾驶小到外卖推荐,都绕不开它。
基础认知:什么是结构化数据标注,通常用在哪儿
结构化数据本身是有固定格式、能按分类存储规整的数据,和杂乱无章的非结构化文本、原图raw数据不一样。
标注就是给这些规整好的数据,打上提前约定好的分类标签,方便AI直接学习读取。
比如电商平台梳理百万级用户评论,要把用户提到的信息拆分到商品尺码、物流速度、售后态度这些固定维度,就是典型的结构化数据标注工作。
再比如银行整理用户的申请授信材料,把用户信息拆分出收入区间、征信记录、负债情况这些固定字段,也属于这类标注。
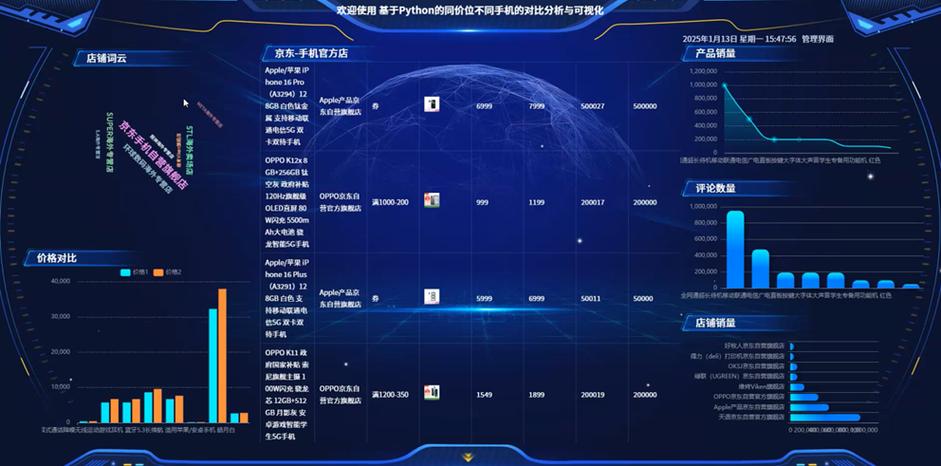 电商用户评论结构化数据标注示例图
实操里容易踩的几个误区
说实话很多刚启动标注项目的小团队,都会在这里走弯路。
比较常见的问题,是提前设定的标签维度太模糊。比如要标用户评论情绪,只设「满意」「不满」两个选项,漏掉了「中性」「混合情绪」,最后标注员全凭个人感受打标,出来的数据根本没法用。
据一些用户反馈,有家做本地生活AI推荐的创业公司,一开始为了赶进度省成本,只设了6个宽泛标签,结果标注完的数据训练出来的模型,准确率比预期低了近两成,最后只能返工重标。返工一次,小半个月的人力就打了水漂。
需要留意的是,一定要做标注一致性校验。不同标注员对同一个标签的理解总有偏差,抽大概十分之一的数据做交叉复核,是行业较为常见的做法。
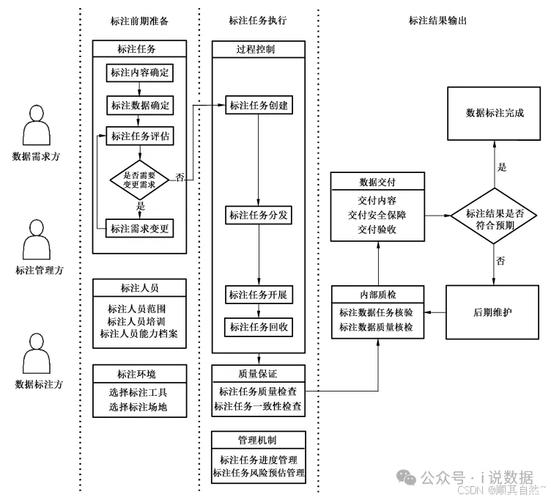 结构化数据标注交叉校验流程示意图
它和非结构化标注的区别在哪
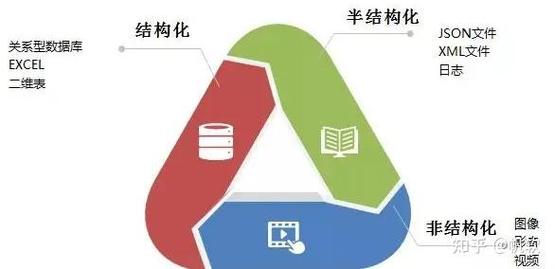 它和非结构化标注的区别在哪
有意思的是很多刚入行的朋友都会把这俩搞混。
简单说,非结构化标注通常是给一整份数据打一个整体标签,比如给一张柯基的图片打「柯基」,就完成了。
结构化标注得把一份数据拆成多个固定维度的字段,每个字段都有提前约定好的可选值。还是拿柯基的图片举例,做结构化标注就得标清楚:品种是柯基,颜色是黄棕白,年龄是幼犬,是否带牵引绳,有没有露脸……这些拆分好的字段,AI可以直接拿来做信息提取训练,不用再自己拆分。
我们通常可以根据模型的目标选标注类型,如果只是做整体分类,非结构化就够用,如果要做信息提取、用户画像这类应用,结构化数据标注就是必不可少的。
您在做数据标注项目的时候,遇到过哪些比较棘手的问题?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:结构化数据标注:AI训练数据整理的核心环节
文章链接:https://m.ttrenwu.com/geo/1891.html
