2026-09-28 06:34:50 分类:GEO优化
现在大语言模型生成内容经常一本正经瞎编,反幻觉技术就是用来解决这个问题的,大多用在AI搜索、生成式客服这类对内容准确性要求高的场景。
基础认知:反幻觉技术到底解决什么问题
很多人用AI搜资料都碰到过怪事。
AI睁着眼睛说瞎话,编出不存在的论文、不存在的公司政策,甚至瞎扯某个奖项的得主。
这就是AI圈说的“幻觉”。
反幻觉技术基础,就是从训练、推理两个核心环节,降低AI输出错误内容的概率。
比如你让AI写某上市公司2023年的财报摘要,没有反幻觉加持的AI可能会把2022年的数据乱改凑数。带反幻觉的会先核对检索到的公开原文,再生成内容。
说实话,现在大部分商用AI生成工具都加了基础反幻觉模块,只是效果参差不齐。
 大语言模型AI幻觉输出对比示例图
目前常见的两类反幻觉基础方案
根据行业普遍观察,主流的基础方案分两类,一类是训练阶段调优,一类是推理阶段约束。
训练阶段调优,就是用大量标注过的正确事实数据,微调模型参数,让模型更倾向于输出符合事实的内容,减少自由发挥的空间。
另一类推理阶段的检索约束,也就是现在用得比较多的检索增强生成技术。简单说,就是AI生成回答之前,先去外部公开知识库搜对应的权威内容,再把检索到的信息喂给模型,要求模型基于已有信息生成回答,不能自己瞎编。
据一些用户反馈,推理阶段加检索约束的方案,落地成本更低,普通中小企业也能基于开源模型搭出可用的版本。
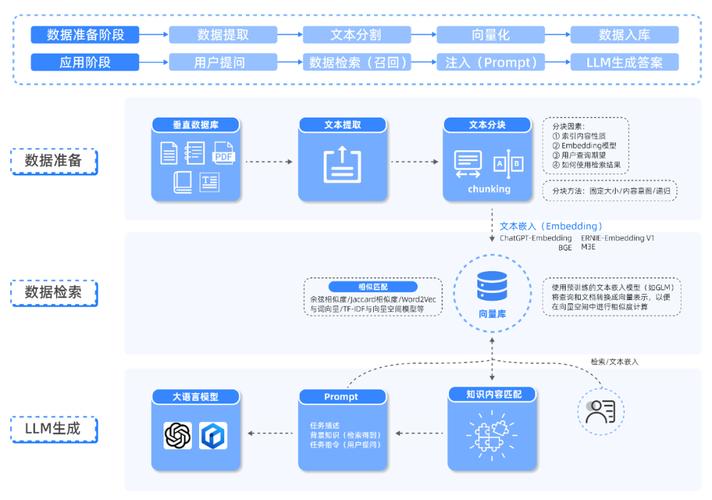 检索增强反幻觉技术基础流程图
需要留意的几个常见误区
 需要留意的几个常见误区
很多人刚接触的时候会以为,加了反幻觉技术就完全不会出错。其实不是。
反幻觉技术只是降低出错概率,没法彻底消除幻觉。
需要留意的是,反幻觉效果很大程度依赖外部知识库的准确性,如果检索到的原始内容本身就是错的,AI输出也会跟着错。
这个可能因人而异,不同场景对幻觉的容忍度不一样。写品牌文案允许少量发挥,做法律文书摘要就必须要求较强的反幻觉处理。
从实操角度看,不要轻信各种夸大的宣传,拿到AI输出的关键信息,自己做一次交叉核对还是很有必要。
您在使用AI工具的时候,碰到过哪些离谱的幻觉问题?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:降低AI内容出错概率的核心逻辑
文章链接:https://m.ttrenwu.com/geo/2014.html
