生成式AI搜索和传统搜索有什么不一样
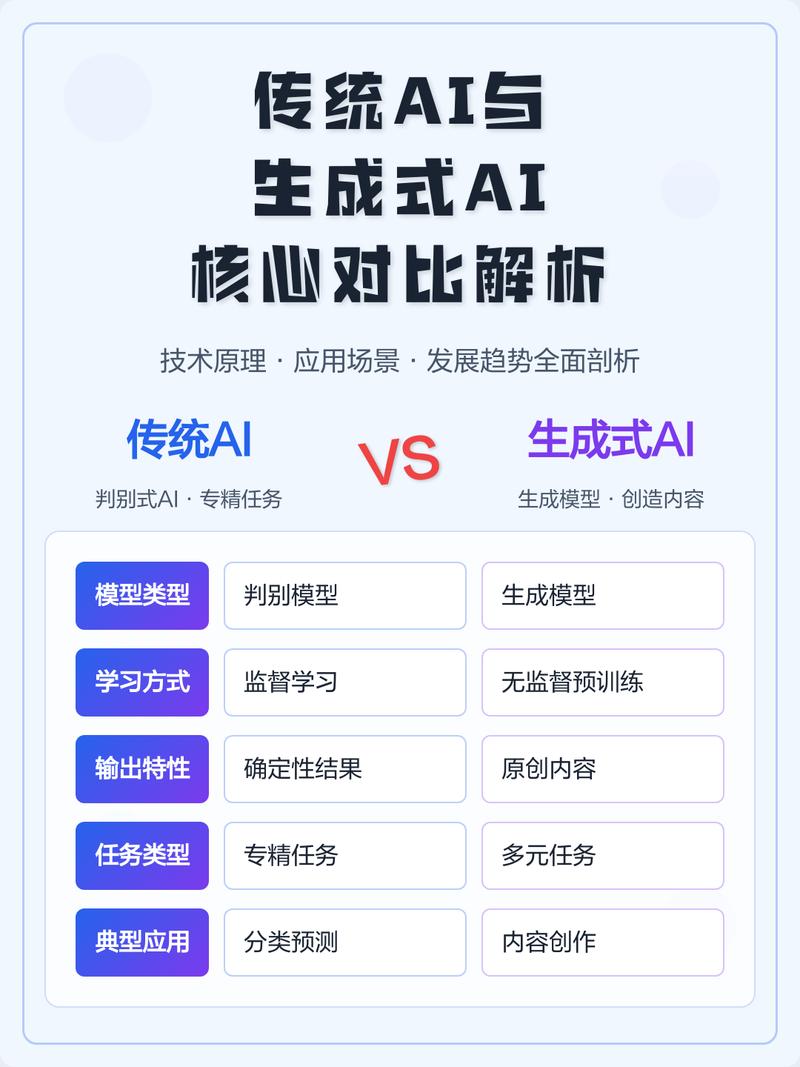
传统搜索的逻辑很简单,就是把你输入的关键词,和它索引的全网网页做匹配,按相关度排序把链接列出来,找答案全靠你自己点进去翻。
生成式AI搜索不一样,它会帮你把找出来的信息重新梳理整合,直接输出符合你需求的回答。
比如你搜“杭州西湖两日游亲子路线”,传统搜索出来一堆景点官网、零散攻略链接,你得自己组合调整;生成式AI搜索会直接给你排好每天的行程,标注适合孩子玩的点,还提醒你哪里需要预约。
生成式AI搜索的核心运行原理
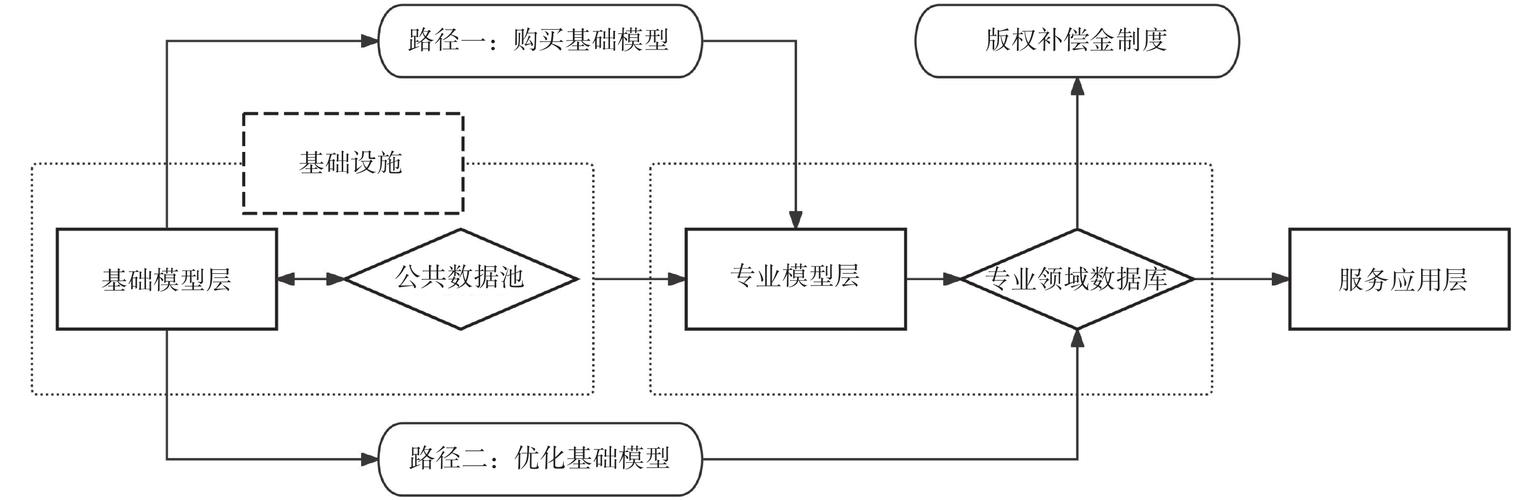
说白了,整个流程分两个核心环节,先检索,再生成,少一个都不行。
第一个环节是检索。大模型本身的训练数据有时间截止,不可能知道最新发生的事,所以拿到你的问题后,AI会先拆解问题关键词,去公共索引库捞取和问题相关的靠谱原始信息,把范围缩小到几十篇相关内容里。
第二个环节就是生成。大模型会把捞出来的碎片化原始信息,按照你的提问逻辑重新组织,揉成通顺自然、符合你需求的回答,通常还会标注每部分信息的来源链接,方便你核对。
使用生成式AI搜索要留意什么
说实话,很多人对它有两个极端误解,要么觉得它全是瞎编,要么觉得它比传统搜索准很多,其实都不对。
据一些用户反馈,生成式AI搜索很容易出现“信息拼接错误”,比如把A景区的开放时间安到B景区头上,或者把去年的政策当成今年的,毕竟大模型生成的时候很容易顺逻辑改内容。
需要留意的是,如果是查不重要的信息,比如做攻略初筛、梳理写作思路,它能省大把时间;如果要找精确的、会影响决策的信息,比如考试时间、办事材料要求,一定要点来源链接核对原始内容。
您在实际使用生成式AI搜索的时候,还遇到过哪些问题?欢迎结合具体场景继续探讨。
