普通人能听懂的基础认知
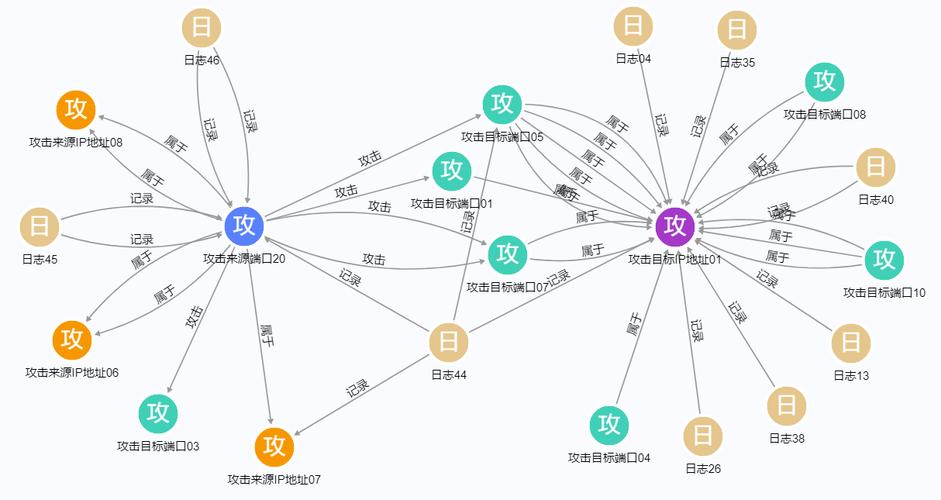
简单说,实体识别就是从一大段文字、语音转写内容里,把有明确意义的独立对象抠出来,比如人名、景点名、商品名、药物名都算实体。 知识图谱则是把抠出来的这些实体,按真实存在的关系连结成一张网,方便快速检索匹配。
举个例子,你在旅游APP搜「西安大雁塔附近的民宿」,实体识别先拆分出「西安大雁塔」「民宿」两个核心实体,再调用知识图谱里提前存好的“位置包含”“业态分类”关系,就能把符合要求的结果列出来。刷短视频时平台能精准识别内容里的明星,给你推同类型内容,也是同样的逻辑。
落地实操的常见误区
很多新手刚接触,会把实体识别等同于关键词提取,说实话不对。同一个词在不同场景可能是完全不同的实体,比如「小米」可以是粮食,也可以是数码品牌,识别不到歧义,后续知识图谱的关系就会连错。
据一些用户反馈,不少小团队做行业知识图谱的时候,一开始就想把所有类型的实体都囊括进去,结果分类混乱,识别准确率大幅下降。
需要留意的是,实体分类一定要贴合自身业务场景,做餐饮图谱就重点抓菜系、商圈、价位这些核心实体,不需要额外加无关的分类,够用就好。
容易搞混的主次关系
有意思的是,不少刚入门的人会搞反两者的顺序。通常来说,实体识别是知识图谱的入口,挖不出正确的实体,知识图谱就是一张没有内容的空网。
不过话说回来,建好的知识图谱反过来也能提升实体识别的准确率。比如知识图谱里已经存了「小米」和“智能手机”“雷军”这些实体的关联,下次遇到「小米发布新品」的文本,就能快速对应到正确实体,不用重新做歧义判断。
从实操角度看,现在大部分中小项目不需要从零训练实体识别模型,用公开的预训练模型,针对自己的行业标注几百条样本微调,就能达到可用的效果。
您在实际接触知识图谱与实体识别的过程中,还遇到过哪些具体问题?欢迎结合实际场景继续探讨。
