2026-10-06 20:44:52 分类:GEO优化
现在不少人用大语言模型查资料写内容,最关心的就是内容来源靠谱不靠谱,引用机制就是用来解决这个问题的功能。
大语言模型引用机制:基础认知与常用场景
说白了,它就是大模型生成内容时,给用到的第三方内容标注原始出处的一套内部规则。
不是什么玄乎的黑科技。比如你让大模型整理今年国内露营经济的行业数据,开启引用机制后,它会把每一段核心观点、数据对应的原始报告链接、发布机构都标注出来,不会把不同来源的内容揉成一团不说来源。
有意思的是,目前大多数带引用功能的大模型,只会标注它能抓取到的公开内容来源,不对内容本身的真实性背书。
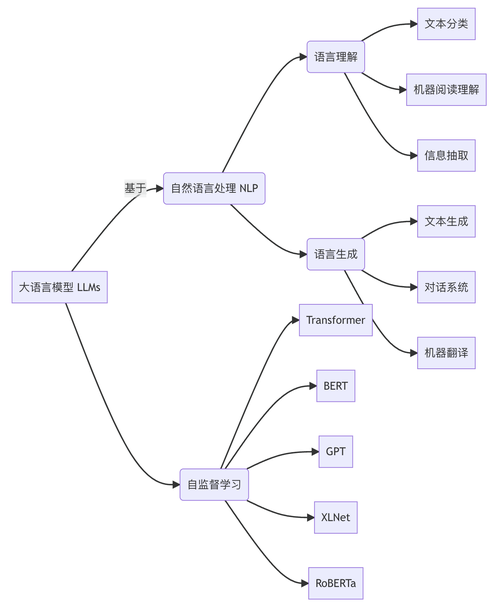 大语言模型引用机制输出界面示例
使用大语言模型引用机制的常见注意事项
据一些用户反馈,最常见的误区就是,开了引用就直接拿来用。
其实大模型的匹配逻辑偶尔会出现张冠李戴的情况,明明某段数据不在标注的来源里,它也会硬挂上。比如在整理学术文献的时候,不少人都碰到过它把A学者的观点标成B学者论文里的内容。
需要留意的是,不同平台的引用机制覆盖范围不同。有些只支持公开网页内容标注,有些可以覆盖书籍、期刊等训练数据里的来源,使用前可以先看看平台的功能说明。
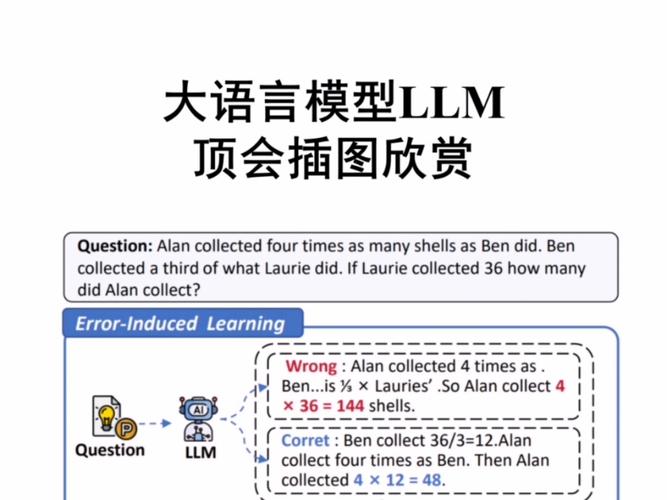 大语言模型引用标注错误案例展示
延伸:它和我们熟悉的参考文献有什么区别
 延伸:它和我们熟悉的参考文献有什么区别
说实话很多人会把这俩搞混。我们写论文的时候加的参考文献,是内容写完之后,按照固定格式手动整理的引用列表,对应全文的标注。
而大语言模型的引用机制是生成内容时实时匹配来源,通常会给每一段内容对应标注来源,更偏向给用户提供信息溯源的路径,格式也不需要完全符合学术规范。
不过话说回来,现在不少面向学术场景的大模型工具,已经可以把引用机制生成的来源直接导出成符合要求的参考文献格式,省了很多手动整理的功夫。
您在实际使用大语言模型引用机制的过程中,还碰到过哪些有意思或者让人头疼的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:拆解大语言模型引用机制:实用场景与注意事项
文章链接:https://m.ttrenwu.com/geo/2430.html
