多模态内容检索,正在帮我们解决混合格式内容里找目标的痛点。
多模态内容检索通常用在哪些场景
和传统只匹配文字的检索不同,它能同时处理文字、图片、语音、视频多种不同格式的内容,提取共同特征做匹配。
比如你在户外拍到一张不知名野花的照片,想找它的养护方法还有相关科普视频,传统检索得你先猜名字输关键词,大概率搜不对。多模态直接传图,就能同时调出图文资料和对应讲解视频。
再比如你只记得某条短视频的大概画面,记不清完整标题,直接截一张风格类似的图加半句台词,就能快速定位原视频。
使用多模态内容检索的常见误区
很多人以为多模态什么内容都能搜,其实不对。
说实话,它对特征模糊的内容识别率通常不高。比如你拍的照片对焦模糊、关键特征被遮挡,就算用多模态也很难给出准确结果。
还有一个容易踩的坑,就是给的多模态信息互相矛盾。比如你搜“蓝色的爱琴海”,配了一张森林落叶的图,系统就会混乱,结果偏差会很大。
据一些用户反馈,同时给多种模态信息的时候,保证不同模态信息方向一致,能把检索准确率提不少。
多模态检索和普通检索的核心差异
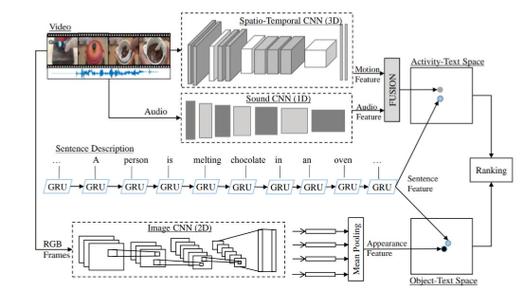
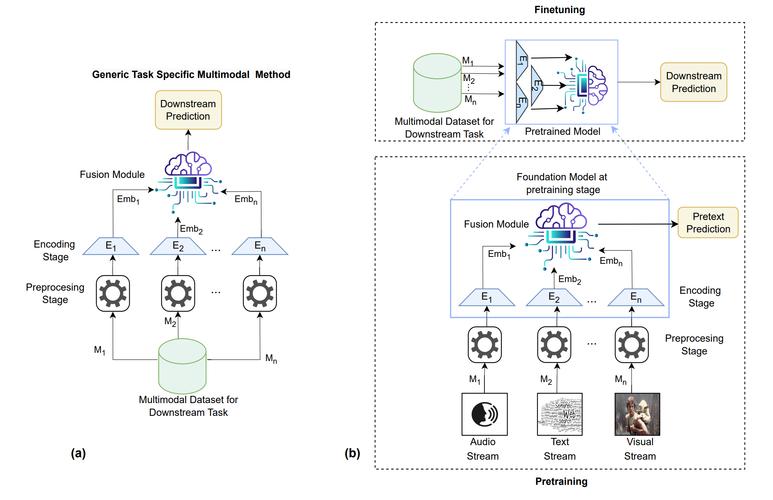
普通检索一般是把所有内容转成文字,再匹配关键词,多模态是直接提取每种格式本身的特征。比如图片的纹理颜色,语音的语调,视频的动作帧,都会纳入匹配逻辑。
有意思的是,现在很多常用的搜索工具都已经接入了这个能力,只是不少普通用户没太留意。
从实操角度看,找特征明确的小众内容时,多模态比纯文字检索省不少时间。这个可能因人而异,有的人还是习惯纯文字检索的逻辑,也没必要硬换。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
