现在我们搜内容早已不局限于输文字,多模态内容检索早就悄悄融入了日常使用场景里。
它到底是什么,通常用在哪些地方
简单说,就是能同时处理、匹配不同类型内容的检索方式。
不同于传统检索只认文字,多模态能搞定文字、图片、语音、视频这些不同格式的内容,还能跨格式匹配。
比如你出门看到陌生人穿了件好看的牛仔外套,直接掏出手机拍一张搜同款,这就是典型的多模态内容检索——用图片匹配电商库的商品内容。
再比如你短视频刷到一个BGM很好听,忘了名字,对着麦克风哼一段就能找到原曲,这也是语音对视频内容的多模态检索。
日常使用需要留意哪些常见问题
很多人觉得多模态检索是万能的,其实不是。
输入内容的质量对结果影响很大,比如你只拍了商品的一个衣角,主体特征不完整,出来的结果大多不对。
据一些用户反馈,用简单手绘草图搜现实物品,匹配准确率通常偏低,除非物品的特征特别突出。
需要留意的是,不同平台的训练数据集不同,检索结果的差异会很大。专业艺术图库的多模态检索对美术作品的匹配度,普遍高于普通综合搜索引擎。
另外,上传你的图片、语音做检索时,部分平台会留存数据优化模型,在意隐私的话可以提前看看平台的相关条款。
它和传统文本检索的核心差异在哪
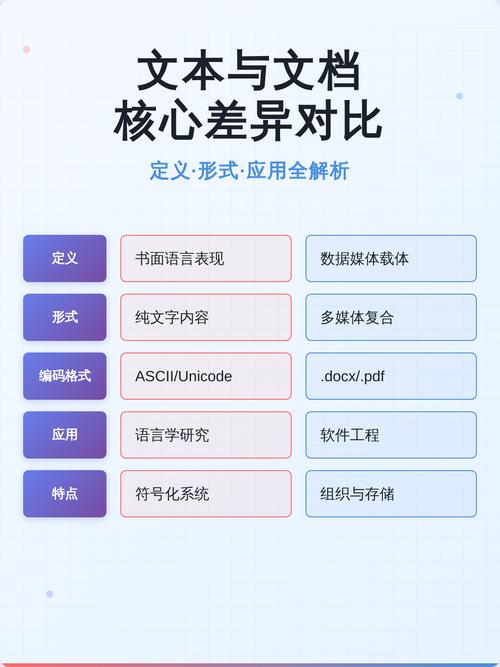
传统文本检索,本质是你输入文字,匹配内容对应的人工文字标签。如果内容创作者忘了打标签,就算内容对得上你也搜不到。
多模态检索不一样,它会直接提取内容本身的特征,不用依赖人工打标签。
有意思的是,现在不少线下展馆都在用这项技术,游客拍一张展厅里的文物照片,就能直接弹出对应的介绍,不用搜名字记编号,体验顺很多。
不过话说回来,目前技术还在迭代,偶尔认错内容的情况还是会有,比如把两只长得像的不同品种狗狗认错,也是常有的事。
您在实际使用多模态内容检索时,还遇到过哪些有意思的状况?欢迎结合具体场景继续探讨。
