2026-10-13 20:12:00 分类:GEO优化
你有没有过这种情况?想找去年在路边拍的那只三花猫的视频,翻了半小时相册都没找着——只记得那天穿了件鹅黄色外套,猫蹲在梧桐树下。
日常里的多模态检索,其实你天天在用
很多人觉得这是离自己很远的前沿技术,其实早就嵌进日常工具里了。比如电商平台拍个衣服找同款,相册里按“带狗的照片”筛选,本质都是多模态检索的应用。
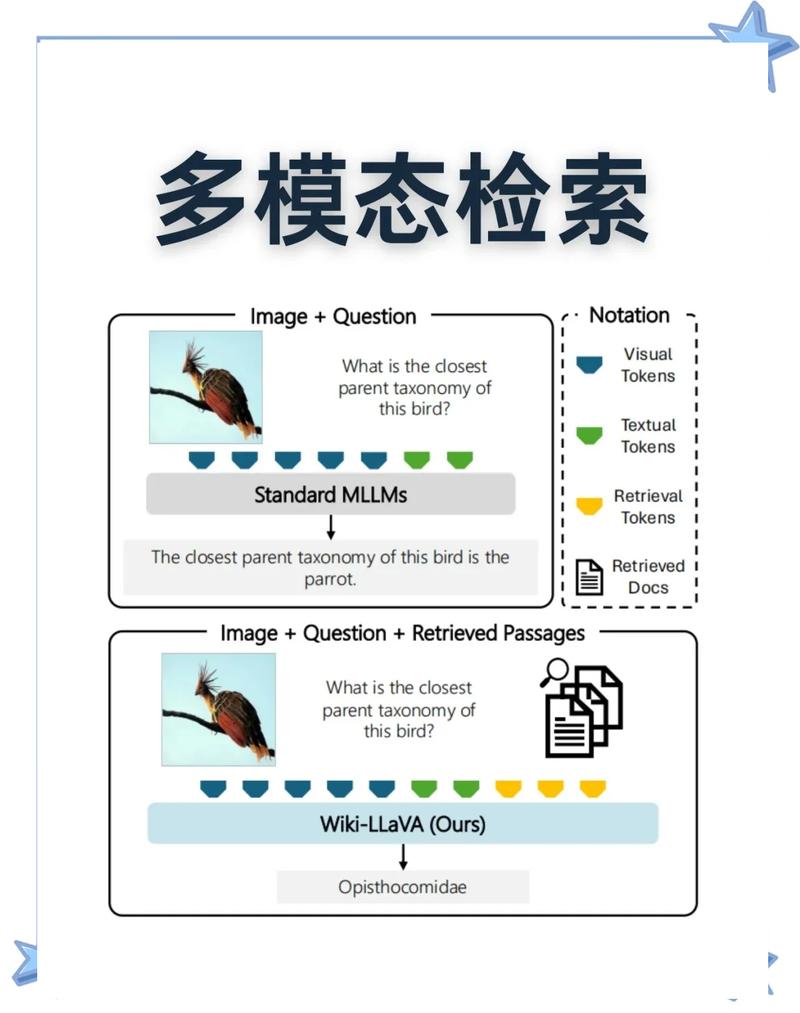 手机相册多模态检索找猫视频操作界面
说白了,就是不用硬凑精准的文字关键词,靠图片、语音、甚至模糊的场景描述,就能把对应的图文、视频、音频内容匹配出来。说实话,我之前总觉得这功能没用,直到上次找旅行vlog翻到手指酸,才反应过来自己之前走了多少弯路。
实操里容易踩的几个小坑
别以为上传素材就能自动获得好的检索效果。
别大意。
素材的基础标注质量,直接影响后续检索的准确率。比如个人整理的家庭素材,如果之前没给视频加过简单的场景备注,系统能识别的维度就只有画面本身。要是你想找“爸爸在厨房唱京剧”的片段,但视频只拍到了他的脸,没拍到厨房环境,大概率就会被漏过。
据一些用户反馈,没有做基础标注的素材库,检索的匹配效率往往比做了规范标注的低不少。
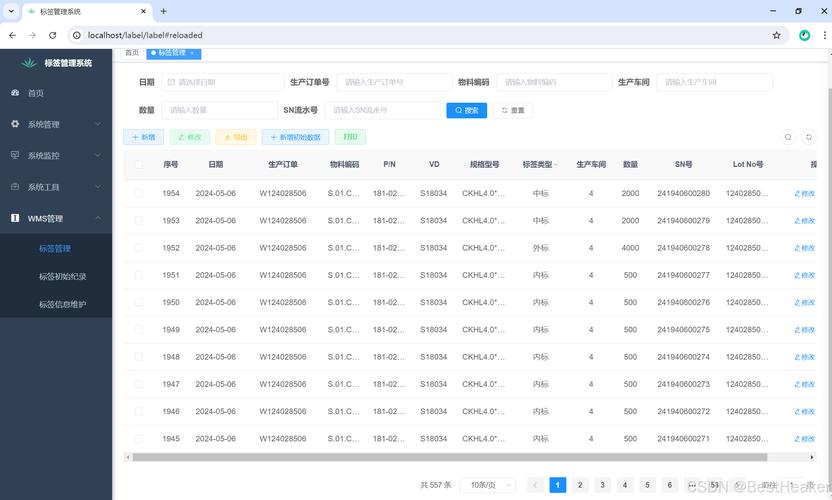 企业内容库多模态检索标签标注后台界面
还有个容易忽略的点,别把所有检索需求都丢给同一个工具。比如你要找的是带特定海浪声的旅行片段,选主打音频特征匹配的工具,比主打画面识别的工具效率高很多。这个可能因人而异,毕竟不同工具的训练数据集侧重不一样。
和传统关键词检索的差别在哪
传统的关键词检索,本质是匹配你输入的文字和素材上预先写好的文字标签。如果你记不清当时给素材起的文件名、写的备注,就很容易找错。
而多模态检索是直接识别素材本身的内容——不管是画面里三花猫的橘白花纹,还是音频里的京剧唱腔,都会被拆成可匹配的特征维度。在一定条件下,这种方式能帮你省掉不少整理素材的精力。
举个例子,你想找“去年夏天在海边拍的、带海浪声的vlog”,用关键词搜的话,得记得当时给文件起的名字是“海边123.mp4”才找得到;用多模态检索的话,直接输入对应的场景描述,或者传一张海边的参考图,就能把对应的内容筛出来。
您在实际找内容的过程中,还遇到过哪些记不清关键词的尴尬情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:多模态内容检索:不用死记关键词找内容的实用思路
文章链接:https://m.ttrenwu.com/geo/2767.html
