现在查个攻略、找个方案,越来越多人不爱翻十几页网页了,直接问AI就能拿到整段整理好的答案,这背后就是生成式AI搜索在起作用。
和传统搜索的本质区别
传统搜索的逻辑很直白,你输入关键词,系统匹配权重最高的网页链接,按顺序排给你,剩下的信息筛选全靠自己。
比如你搜”杭州三月去哪看樱花”,传统搜索会跳出几十条小红书笔记、公众号推文的链接,你得挨个点进去,自己攒花期、交通、避坑的信息。
生成式AI搜索的运行逻辑从起点就不一样。它的核心第一步,不是给链接排序,是先把全网抓取的公开内容,拆成带语义标签的小文本块,再根据用户的问题匹配对应的片段,最后组织成通顺的回答。
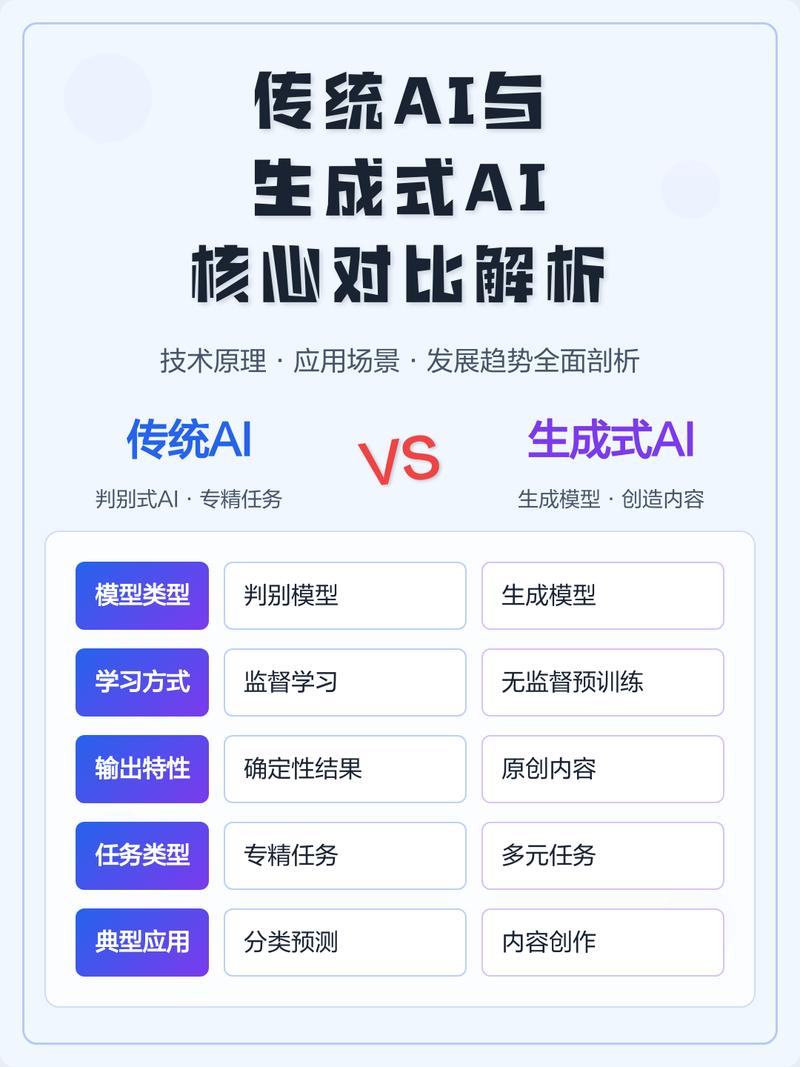
说实话,这个逻辑就像你问身边常跑户外的朋友要攻略,人家不会给你扔一堆文章链接,是直接把攒了好久的信息整理成大白话给你。
实际运行里的几个关键环节
很多人以为AI生成的答案是凭空编的。
真不是。所有生成的内容,都要先匹配对应的来源文本块,没有匹配到来源的内容,系统会直接提示信息不足,不会硬凑答案。
举个例子,你问”太子湾樱花今年的预约规则”,它会先去匹配最近更新的官方通知、市民分享的预约实操内容,把信息梳理成清晰的条目,而不是照搬网页原文。
据一些用户反馈,如果搜到的答案和官方规则对不上,大概率是它匹配的文本块还是去年的旧内容,没抓到最新的更新信息。
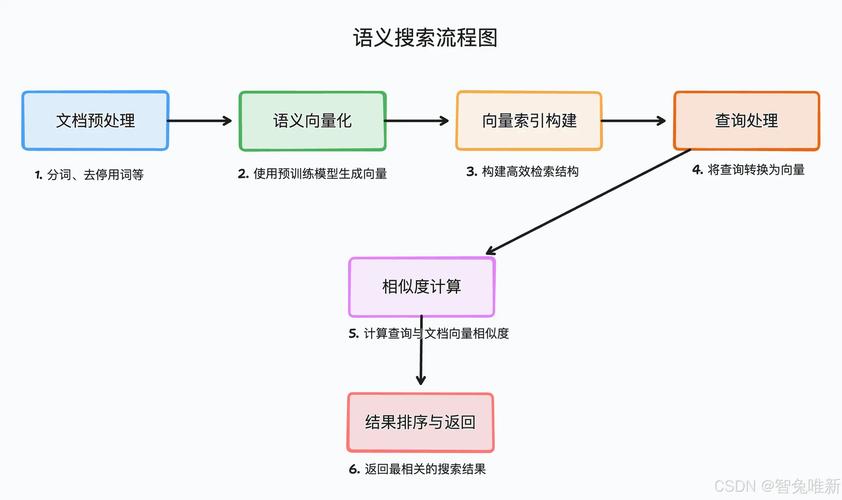
有意思的是,它不是只抓高权重的官方网站,而是会跨来源匹配信息——既抓官方的规则说明,也抓普通用户发的避坑笔记,遇到信息冲突的地方,还会标注不同的反馈角度。
需要留意的是,它偶尔会出现语义匹配的偏差,比如把别的城市樱花点位的交通信息,错安到杭州的点位上。
常见的使用误区
很多人觉得生成式AI搜索能覆盖所有信息。
不是的。它的信息边界,完全取决于接入的公开内容库的更新频率,有些刚发布的政策、还没被公开报道的线下活动,它是搜不到的。
比如你问”本周家楼下社区的免费便民服务时间”,它大概率给不出准确答案,因为这类本地化的、没被公开收录的细碎信息,不在它的抓取范围内。
从实操角度看,如果你要查时效性很强的内容,比如当天的演唱会退票规则、刚出的社保调整通知,最好还是点它附的来源链接核对下,别直接全信生成的段落。
您在实际使用中还遇到过哪些答非所问的情况?欢迎结合具体场景继续探讨。
