2026-10-14 14:46:08 分类:GEO优化
现在不管是搭企业内部知识库问答,还是做面向普通用户的智能客服,大模型张口就编的毛病,已经成了落地过程中比较卡人的问题。
先搞懂:反幻觉不是让大模型“变聪明”
很多人刚接触的时候,会把反幻觉等同于给大模型喂更多、更全的知识。
不对。
据一些用户反馈,光堆知识库内容反而容易让模型“张冠李戴”,把A文档里的内容安到完全不相关的问题上。
举个真实碰到的例子:之前有用户问某款老版本办公软件的导出格式,大模型硬说支持带图层的PDF矢量导出,实际那款版本根本没开发这个功能,折腾了用户快半小时。
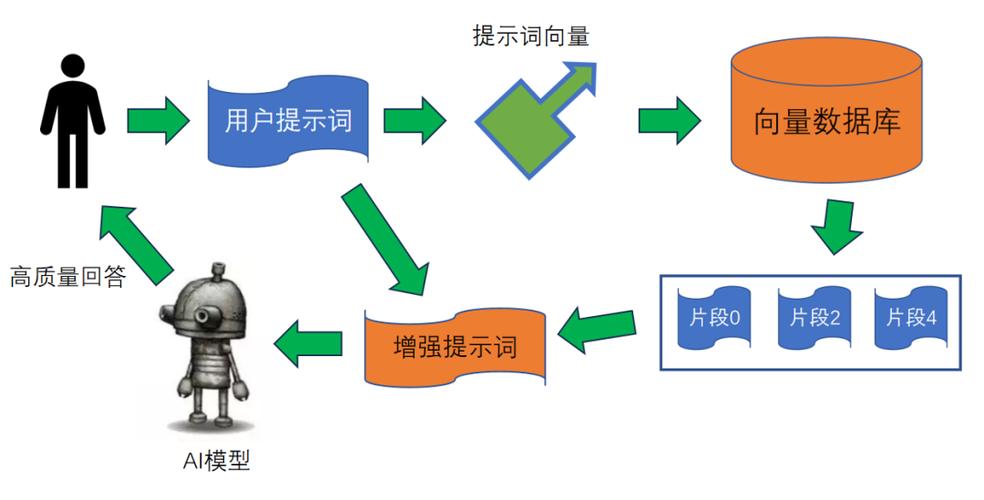 企业知识库问答场景反幻觉流程示意图
其实反幻觉技术的核心基础,是给模型的输出套上“可溯源的约束”——每一句有事实属性的回答,都要绑定对应的知识来源片段,没有可靠来源支撑的内容,就不允许随便生成。
听起来简单。
真落地的时候,细节差一点,效果就差很多。
实操时容易踩的几个坑
说实话,我见过不少团队在这上面花了冤枉钱。
第一个常见误区,是觉得把知识库的文本切得越细,反幻觉效果就越好。
从实操角度看,文本切得太碎的话,模型很容易把上下文拆得支离破碎。比如本来是“2024年修订的某条款生效时间是2024年3月”,结果把“生效时间2024年3月”单独切成了检索块,碰到问旧版条款生效时间的问题时,模型就容易张冠李戴。
还有个容易忽略的点:反幻觉不是要求模型把所有没把握的回答都改成“我不知道”。那样的话用户体验会差到没人愿意用。
举个例子,用户问“怎么在系统里提交差旅报销”,模型如果因为没检索到完全匹配的片段,就直接回“不知道”,那这套系统基本就失去了实用价值。
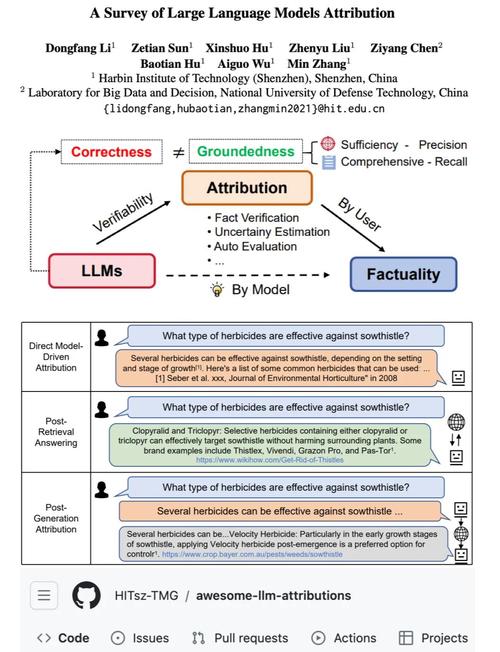 大模型输出溯源标注样例图
和模型微调的认知差异
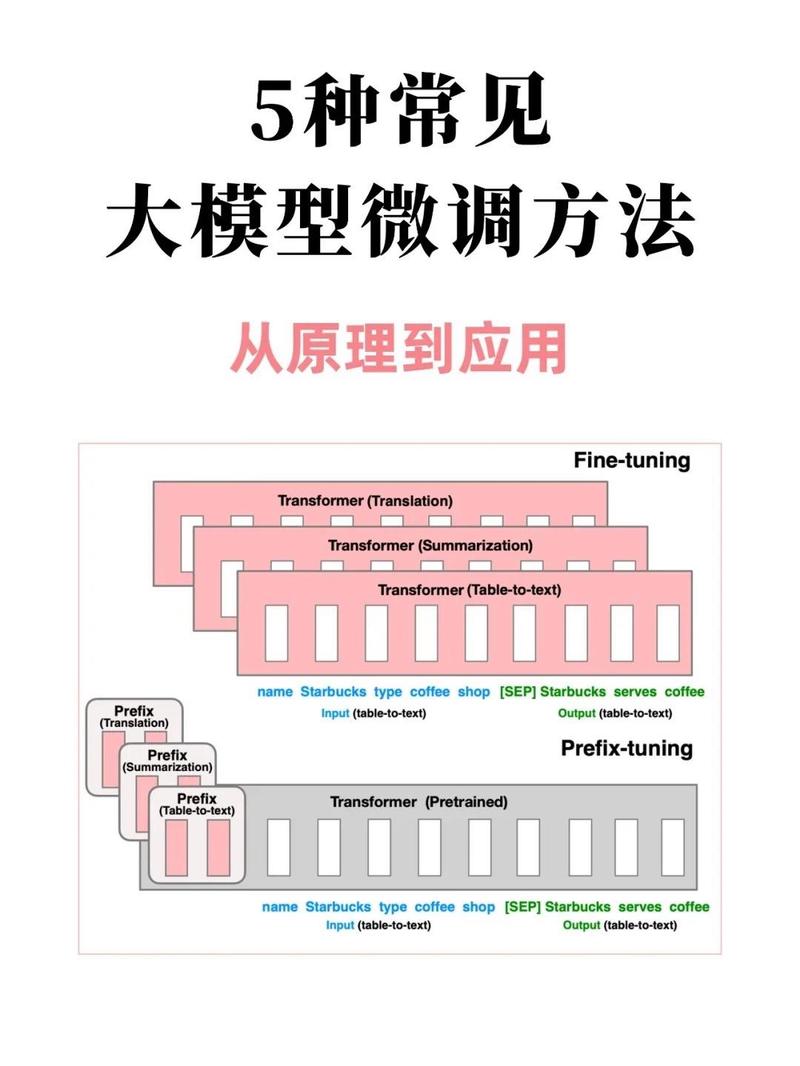 和模型微调的认知差异
很多人会把反幻觉技术和模型微调混为一谈。
其实两者的作用逻辑完全不在一个层面。微调是从模型的参数层面,调整它的生成习惯;而大部分反幻觉的基础技术,是在模型的外层搭约束框架,不需要改动模型本身的参数。
根据行业普遍观察,对于大部分中小规模的应用场景,外层做检索约束、加溯源校验的投入,比从头微调模型的性价比要高不少,也更灵活——比如知识库更新了,只要同步更新检索的内容就行,不用重新跑一遍耗时耗力的微调流程。
您在实际使用中还遇到过哪些大模型一本正经编内容的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:大模型落地时绕不开的实用逻辑
文章链接:https://m.ttrenwu.com/geo/2802.html
