2026-10-15 05:31:12 分类:GEO优化
知识图谱与实体识别的组合,是现在很多内容检索、智能客服、电商推荐系统能精准命中用户需求的核心底座之一。
先搞懂:二者到底是怎么配合干活的
你在电商APP搜“苹果的最新款手机”,系统不会跳出一堆红富士水果链接——这就是实体识别在起作用。它先把文本里的核心要素抽出来:品类是手机,品牌是苹果,属性是最新款。这些抽出来的实体,再和知识图谱里存储的“苹果公司-旗下产品线-iPhone系列”的关联做匹配,才能调出对应的商品条目。
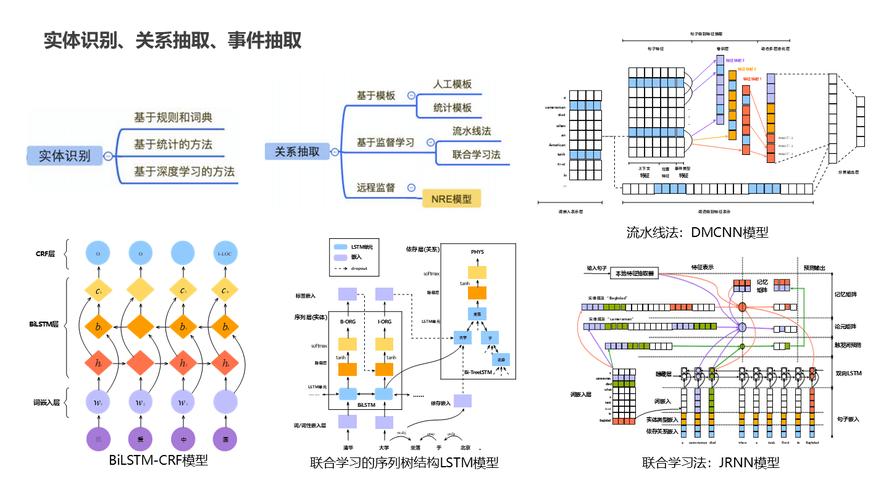 知识图谱实体抽取流程示意图
别觉得这俩技术离普通人很远。你平时用智能客服查快递,问“我的京东快递昨天寄的到哪了”,系统能精准识别出快递平台、寄件时间这些实体,再匹配对应数据库的物流信息,本质上就是这套逻辑在跑。
实操时容易踩的几个坑
很多团队做项目初期,恨不得把所有可能出现的实体类型都塞进识别库,从人名地名到小众网络热词全覆盖,结果模型训练半天,识别准确率反而上不去。据一些用户反馈,初期收敛实体类型范围到业务核心相关的3-5类,比如做餐饮本地号的,先聚焦“餐厅名称、菜品、商圈”这三类,识别准确率通常能有明显提升。
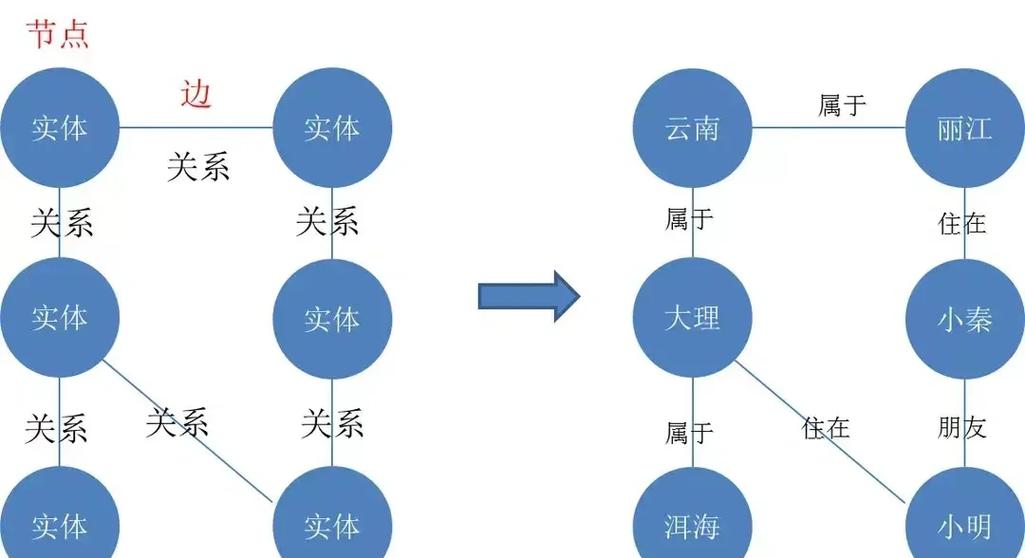 垂直领域知识图谱实体标注示例图
还有个常见误区:把实体识别的结果直接丢进知识图谱就完事了。要记得实体消歧啊。比如文本里出现“朝阳”,是指北京朝阳区,还是辽宁朝阳市,还是叫“朝阳”的某个人?这种歧义如果不做上下文校验,存进图谱的关联关系全是错的,后面检索出来的结果自然驴唇不对马嘴。我们通常可以结合实体出现的上下文、业务场景的常规范围做二次校验,减少错配。这步很关键。
和大家常搞混的几个概念差在哪
很多人会把实体识别和普通的关键词匹配搞混。说白了,关键词匹配是只要文本里出现对应字符就算命中,比如搜“华为”,不管是说华为手机还是华为参与的公益项目,都会被抓出来;但实体识别是要判断这个词在当前语境下的具体指向,是归到“企业主体”类,还是“消费品牌”类,还是“公益项目参与方”类。
还有人觉得知识图谱就是普通的关系数据库。其实差别挺大的。传统数据库是靠人提前写好的查询语句去取数,知识图谱可以顺着实体的关联关系做推理,比如你问“和周杰伦合作过的90后歌手有哪些”,系统可以顺着图谱里“周杰伦-合作对象-歌手”的关联,自动筛出符合年龄条件的结果,不用提前写死所有查询路径。
您在实际使用这类技术搭建业务系统时,还遇到过哪些识别不准、关联错配的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:知识图谱与实体识别:从日常场景到落地实操的实用拆解
文章链接:https://m.ttrenwu.com/geo/2830.html
