写行业报告、做科普内容甚至发自媒体笔记时,引用质量评估已经成了不少内容创作者绕不开的动作。
引用质量评估到底在评什么
我们通常不用把它想成多么高深的学术流程。核心就是核对你拿来当论据的引用内容,和你要表达的观点是不是匹配,来源是不是站得住脚。
举个例子,你写”城市骑行道的建设现状”,引用了某博主去年拍的本地骑行道实拍素材,配了对应的路口定位和拍摄时间,这种引用的参考价值就比较高。要是你随手引了某篇三年前的外地骑行攻略,根本没对应本地的实际情况,就算把原文抄得一字不差,也算无效引用。
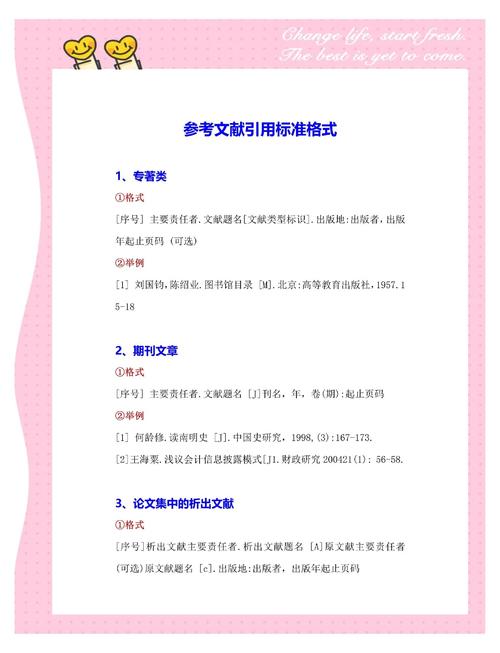
说实话,很多人对引用的认知还停留在”凑参考文献数量”,完全没意识到无效引用帮不了内容,还可能让读者直接失去信任。
实操时容易踩的几个误区
较为常见的坑是不管来源的时效性。比如拿2019年的在线教育用户规模数据,去分析2024年的行业变化,数据本身的参考价值已经打了折扣。
再就是容易犯断章取义的错。看到某份消费报告里写”Z世代群体对户外露营的偏好度较前年提升30%”,直接掐掉”较前年””偏好度”的前提,写”Z世代30%的人都爱露营”,这种偏差很容易误导读者。
另外不少人图省事,直接拿无溯源的二手内容当依据。比如刷到某条短视频说”某类护肤品的成分致敏率达20%”,找不到对应的公开测试报告就直接引用,风险其实挺高的。
别不当回事。
据一些用户反馈,之前做科普内容时随手引了几个二手来源,后来被读者追着要原始数据,花了两三天才把所有引用的溯源核对完,反而耽误了内容发布节奏。
和常见的”引用查重”有啥区别
很多人会把这两个动作搞混。查重的核心是检查你的内容和已公开内容的重复比例,属于合规层面的校验。
但引用质量评估的核心,是判断你引用的内容本身靠不靠谱、能不能匹配你的论点,属于内容可信度层面的校验。
有意思的是,不少人觉得查重过了就万事大吉,结果内容里全是来源不明的引用,就算重复率再低,也很难让读者信服。
您在实际整理内容、核对引用的过程中还遇到过哪些棘手的情况?欢迎结合具体场景继续探讨。
