2026-10-17 12:07:24 分类:GEO优化
现在不管是用大模型写项目方案、查专业资料,还是给学生做学习辅助,最怕碰到的就是它一本正经瞎编内容的情况——反幻觉技术就是现在所有大模型落地场景里,优先要搭的底层能力。
基础认知:反幻觉不是“让模型变聪明”
很多人对反幻觉的第一反应,是要把模型训练得更准、更博学。
真不是。
从实操角度看,现在主流的反幻觉逻辑,更像给模型配了个实时的“资料核对员”——它输出的每一句涉及事实的内容,都要先去匹配已经过合规校验的可信知识库,匹配不上的内容就不会往外说。
举个例子,企业内部用的智能客服,就不会让模型随便答售后规则,所有涉及赔付、退换的内容,都必须从官方的规则文档库里检索匹配,不然就只会引导用户对接人工渠道。
 大模型幻觉输出真实案例截图
你碰到过模型瞎编参考文献的情况吗?本质上就是反幻觉校验没跟上,把模型自己生成的虚构内容,当成了真实资料输出了。
比较容易踩的几个反幻觉建设误区
很多人觉得把知识库堆得越满,反幻觉效果就越好。
不对。
实际上如果知识库本身有错误内容,再强的检索匹配逻辑,也会把错的内容当成真的输出出去。知识库内容的准确性优先级,往往比知识库的容量更影响最终的反幻觉效果。比如之前有团队把多年前的旧版产品手册直接导进知识库,结果客服给用户报的还是早就停产的旧款产品参数,闹了不少投诉。
还有个常见误区,就是觉得做了检索匹配就够了。据一些用户反馈,就算知识库内容全对,有时候模型也会断章取义,把检索到的不同段落的内容拼错,张冠李戴。语义一致性校验环节,是很多团队容易漏掉的步骤。通常现在会在检索环节加一层逻辑校验,核对模型输出的内容和检索到的原文语义是不是匹配度足够,差得太多的话就触发重写,或者直接退回人工处理。
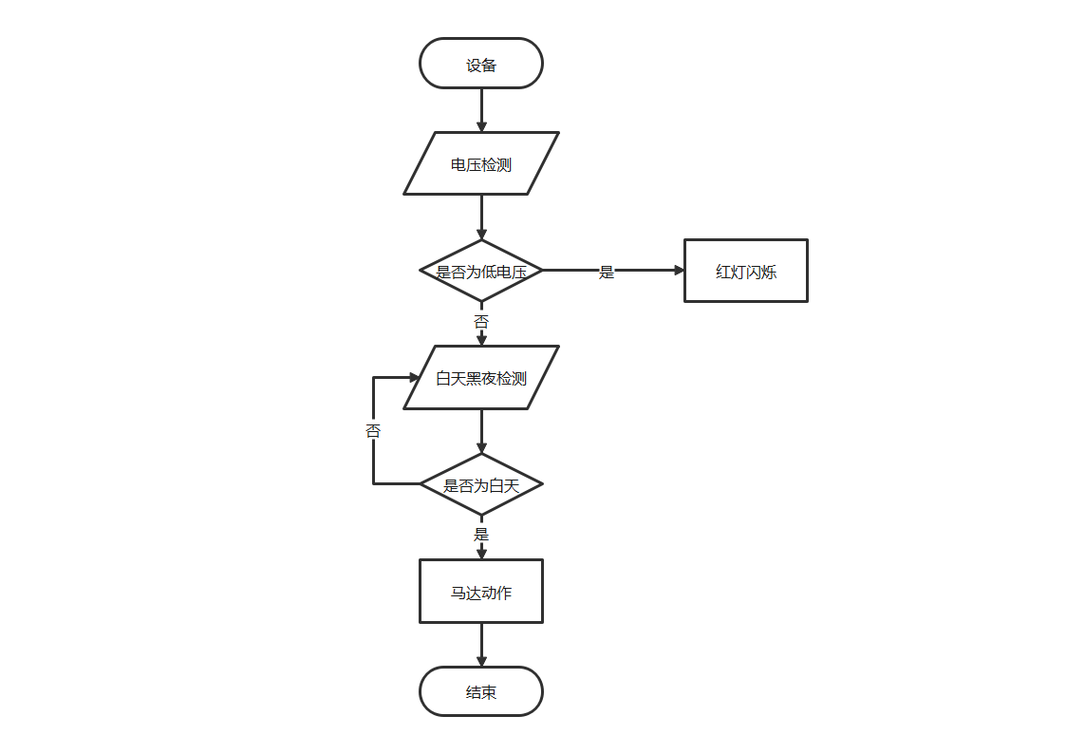 企业知识库反幻觉校验流程图
需要留意的是,反幻觉不是要把所有模型输出都卡死。比如涉及创意写作、头脑风暴的场景,本来就没有标准答案,就没必要套太严的校验规则,不然输出的内容会干巴巴的,根本没法用。
延伸视角:反幻觉技术的能力边界
 延伸视角:反幻觉技术的能力边界
很多人会把反幻觉和模型微调搞混。其实微调是让模型更贴合某个行业的表达习惯,反幻觉是给模型的输出加一道事实安全锁,两者是搭配用的,不是替代关系。
比如做法律场景的大模型,先通过微调让它熟悉法律文书的表述逻辑,再搭反幻觉的检索校验层,让它引用的法条必须和现行有效的法律条文对应,不能自己编司法解释。
有意思的是,现在不少做反幻觉的团队,根本不去改动模型本身的参数,就是靠外层的检索、校验、规则拦截逻辑,就能把事实类错误率压到较低的水平。
您在实际使用大模型的过程中,还碰到过哪些让你印象深刻的幻觉输出?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:大模型落地不瞎编的实用逻辑
文章链接:https://m.ttrenwu.com/geo/2918.html
