2026-10-17 14:37:30 分类:GEO优化
刷到一段没头没尾的猫咪踩奶短视频,想找原片、找同款猫砂广告、甚至找同款BGM,靠打关键词搜往往找不准——这就是多模态内容检索较为常见的落地场景。
日常场景里的多模态检索,到底在做什么
很多人以为这是实验室里的前沿技术,其实你平时用的拍照搜题、以图搜同款衣服,本质都是这类检索能力的落地。
举个例子,去年我朋友在咖啡馆拍到邻桌穿的一件灰绿色复古夹克,直接用相册的搜图功能,3秒就找到品牌官方的商品链接,根本不用对着记忆里的“毛呢 灰绿 夹克 宽松”打一堆字试错。真的省事儿。
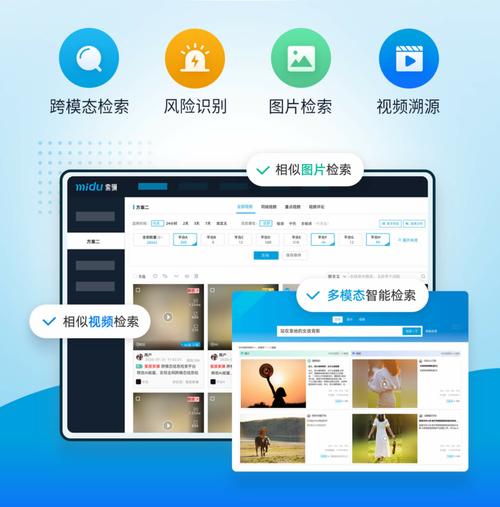 手机相册跨模态检索商品操作界面
它的核心逻辑,是把文字、图片、音频、视频的特征都拆成统一的向量维度,不管你传的是一段10秒的街拍视频,还是一段随口哼出来的旋律,系统都能匹配到对应特征的内容。
有意思的是,现在不少内容平台已经把这个功能藏在搜索框的小图标里了,很多人用了大半年都没发现。
实际用的时候,容易踩的几个误区
首先别拿模糊到看不清的图去搜。据一些用户反馈,传一张对焦糊到只剩色块的美食图,系统大概率会给你匹配一堆同色系的无关内容,根本识别不出你要找的是哪家的芒果千层。
需要留意的是,不同平台的检索训练集有明确边界。比如你在笔记类平台传一张手绘的动漫角色,可能匹配不到同角色的官方cosplay视频,因为两边的内容库根本没打通。
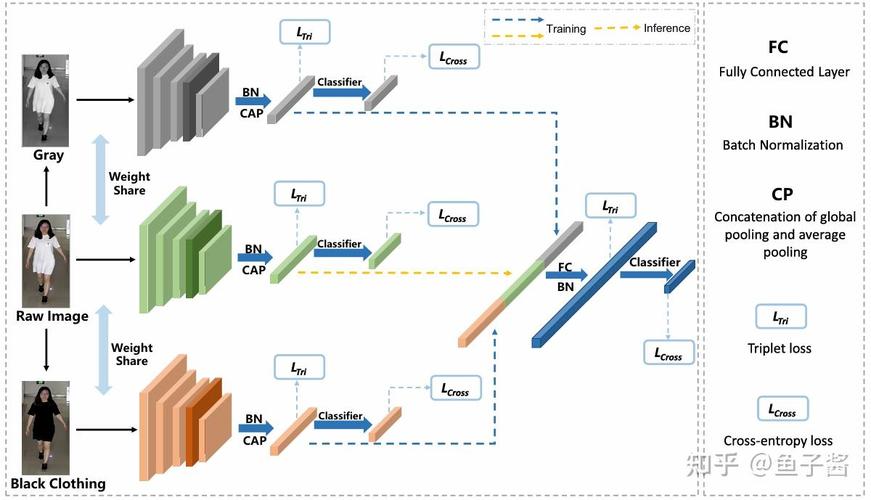 多模态向量空间特征匹配示意图
还有个常见的坑:很多人以为传一段现场录的演唱会饭拍,就能找到整场演出的官方录像。实际上如果现场环境噪音太大,音频特征被盖掉,匹配结果往往会偏到同歌手的热门单曲列表里。
和传统关键词检索的核心差异
 和传统关键词检索的核心差异
说实话,传统检索是“你说什么我找什么”,你得把脑子里的需求转换成精准的文字描述,但凡描述差一个形容词,结果就偏十万八千里。
多模态检索更贴近“匹配你要找的感觉”,你不用费劲把记忆里的“夏天傍晚巷口卖冰粉的小推车”转换成一长串关键词,直接传一张去年拍的糊图,系统就能把同场景、同氛围的内容都捞出来。
从实操角度看,现在不少做内容整理的人,已经开始用这个功能给个人相册打标签,不用手动给几千张旅行照片写备注,系统自动就能把同个地点、同个活动的照片归到一起。
您在实际使用中还遇到过哪些检索不准的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:多模态内容检索:跨图文音视频找内容的实用逻辑
文章链接:https://m.ttrenwu.com/geo/2924.html
