很多人用AI查资料时,都遇过输出内容找不到出处、甚至瞎编的糟心情况——大语言模型引用机制就是为解决这类问题设计的实用功能。
日常用的引用机制到底在做什么
说白了,就是大模型生成回答时,会把内容对应的信息来源、出处片段标在对应位置。
举个例子,你问2024年国内新能源汽车的销量数据,带引用机制的模型不会直接甩个数字,会在数字后面标上对应的乘联会公开报告链接,点进去就能看到原始数据。
这个机制不是什么高深的技术。本质是给AI的输出加了溯源标签,降低模型生成虚构内容的概率。据一些用户反馈,用带引用的模型查学术资料、行业公开数据时,遇到内容失实的情况会少很多。
用的时候要留意哪些细节
需要留意的是,不是所有标了引用的内容都完全可信。
有些模型会把和问题相关性不强的来源硬凑上去,看起来有标注,实则点进去找不到对应内容。从实操角度看,我们通常可以先看引用的来源是不是对应问题的原始出处——比如查政策文件,优先看政府官网的引用,而不是自媒体转载的链接。
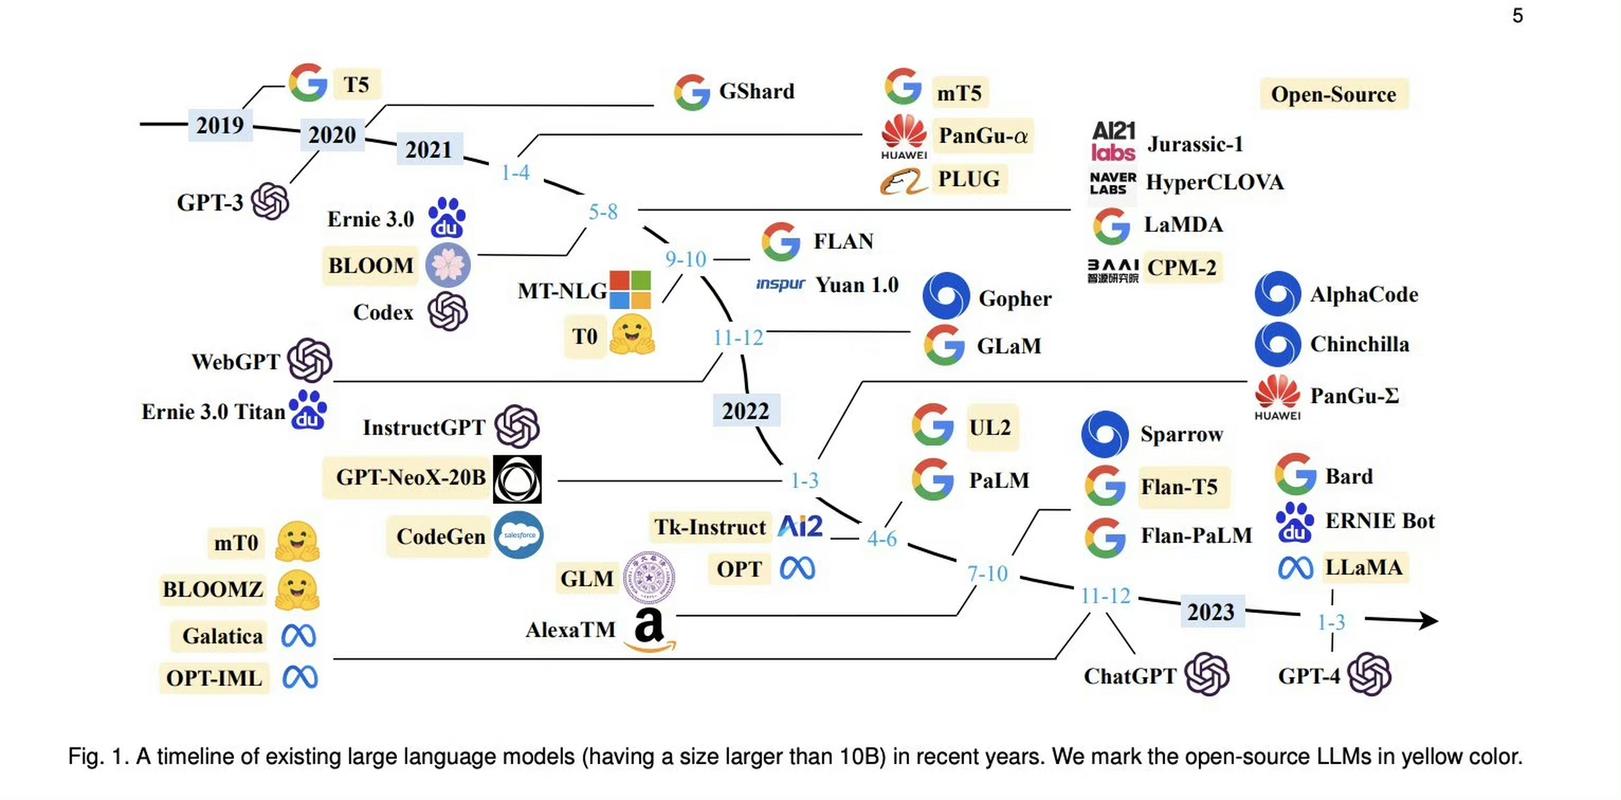
还有个容易忽略的点:部分模型的引用只会标来源链接,不会展示对应的原文片段。遇到这种情况最好手动核对下引用内容和原始信息的匹配度,别直接全信。比如你查某条法律的条文,模型标了某法律数据库的链接,点进去发现对应的是旧版条文,这时候就要自己核对最新版本的内容。
和传统搜索的来源标注有什么区别
有意思的是,很多人会把这个机制和传统搜索引擎的来源标注搞混。
传统搜索的来源是给你列一堆相关链接,你要自己翻找对应内容;但大语言模型的引用是直接把生成的内容和来源片段绑定,哪句话来自哪个来源,对应关系更明确。当然也有适用边界,它没法覆盖所有小众、未公开的信息,遇到这类问题还是得自己找原始渠道核实。
您在实际使用中还遇到过哪些引用机制踩坑的情况?欢迎结合具体场景继续探讨。
