结构化数据标注不是什么玄乎的技术。
它本质上是给零散的信息加上统一的、机器能读懂的标记,不管是训练大模型做内容识别,还是让搜索引擎准确抓取网站内容,很多都靠它打基础。
日常里常见的标注场景
举个很通俗的例子,你在电商平台搜”纯棉短袖T恤”,能直接跳出带价格、尺码、库存的商品卡片,不是平台瞎猜的——是商品页提前做了结构化数据标注,把商品的品类、材质、价格这些信息用统一的标记标出来了。
还有你手机里的相册能自动把”猫”的照片归到一个相册里,背后也是标注人员提前给成千上万张照片打了对应标签,训练模型识别出来的。
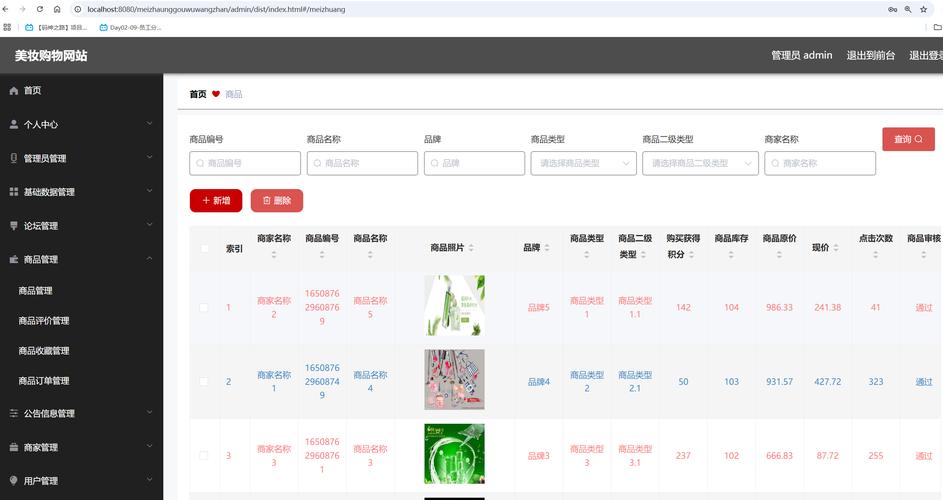
说实话,很多人一开始觉得标注就是”打标签”,没什么技术含量。真上手才知道,标错一个字段,后面整个模型训练或者搜索展示的效果都会歪。
实操里容易踩的几个坑
很多团队一开始定标注规则的时候,只写大方向,不给边界例子。比如要求标注”正面评价”,那”这个手机续航够我用一天”算正面?”续航勉强够一天,比上一代差远了”算什么?规则里没写清楚,十个人标出来十个样。
还有人觉得标完就完事了,根本不做抽检。据一些用户反馈,同一批标注数据里,要是抽10%出来复核,经常能查出两成左右的错误,要么是标漏了字段,要么是分类标反了。
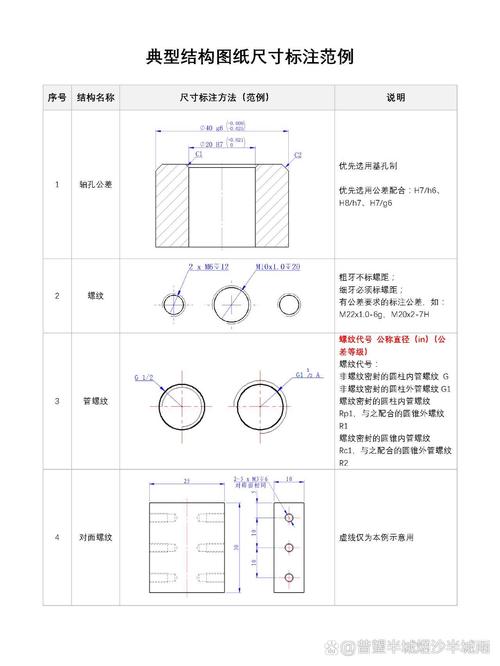
这个可能因人而异,不过从实操角度看,通常可以每100条标注里留10条做交叉复核,两个人标同一批数据,要是一致性低于80%,就得回去调整规则,别硬着头皮往下做。
和普通数据整理的区别
很多人会把结构化数据标注和普通的Excel整理搞混。其实差得挺多的。
普通整理是给人看的,你自己做的表格自己能看懂就行。但标注是给机器读的,所有字段的命名、分类的层级、甚至标点符号都要严格统一——比如你给商品标价格的时候,一会儿写”99元”,一会儿写”¥99″,机器就识别不出来这是同一个字段的信息。
有意思的是,现在不少标注工具都内置了规则校验,能自动揪出格式不对的字段,省了不少人工复核的功夫。
别嫌麻烦。毕竟后面所有基于这些数据做的模型训练、搜索展示、用户推荐,效果好不好,很大程度上取决于前期的标注够不够准。
您在实际做结构化数据标注的时候,遇到过哪些规则边界模糊的情况?欢迎结合具体场景继续探讨。
