现在不管是搜日常攻略还是查内部文档,大家碰到搜出来的结果驴唇不对马嘴的情况,多半都和语义检索与匹配的落地效果直接相关。
基础认知:和传统关键词检索的核心差异
以前大家熟悉的检索逻辑,本质是“字面对齐”。
比如你搜“适合猫抓的沙发材质”,传统系统会把所有同时带“沙发”“猫”“材质”关键词的内容全捞出来——哪怕帖子讲的是“猫抓坏沙发怎么补”,根本没提什么材料耐抓。
语义检索与匹配的核心,是跳出字面对齐,真正理解用户的真实意图。
它不会纠结你说的是“抓不烂的沙发”还是“耐猫抓的面料”,只要意图一致,就能匹配到对应的内容。
有意思的是,很多人觉得这套技术离日常很远,其实不管是外卖平台的菜品搜索、APP里的帮助中心问答,背后都跑着这套逻辑。
实操落地:几个常见的踩坑点
从实操角度看,很多团队一开始做语义检索与匹配,上来就选参数最大的模型,完全不做前置准备。
别上来就堆大模型资源。真的没必要。
比较常见的问题是直接把格式混乱的旧文档、过期的业务手册一股脑丢进向量库,最后搜出来的内容全是错的、过时的。
还有个容易忽略的细节,很多团队觉得语义匹配能搞定所有问题,完全不做规则兜底。比如用户搜“怎么申请离职”,结果系统把同音字的“申请离值(值班的‘值’)”旧文档匹配出来,这种小bug足以把用户的耐心耗光。
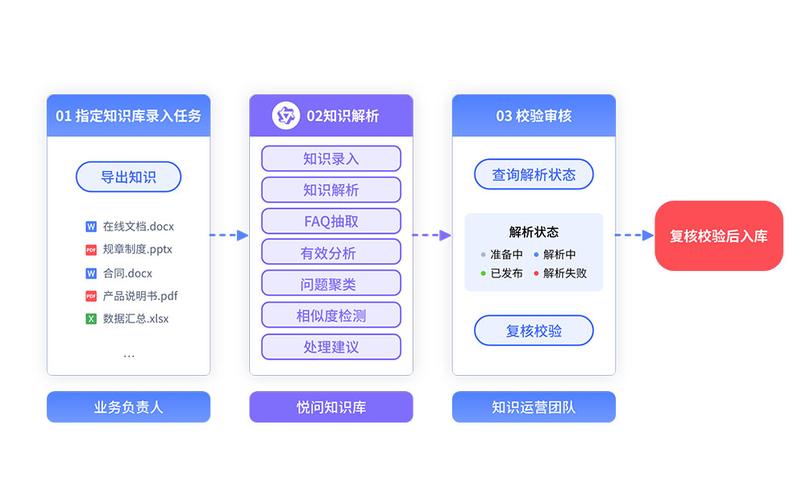
据一些用户反馈,语义匹配的效果不是上线就一成不变的。通常每过两三个月,就要把用户高频搜索但没得到正确结果的query拉出来复盘,补全对应的知识库条目,不然时间长了,新的业务内容没覆盖,老的匹配逻辑会慢慢失准。
延伸视角:和向量检索的概念边界
很多人会把语义检索与匹配和向量检索混为一谈。
向量检索只是实现语义匹配的其中一种技术路径,不是全部。
比如在前台咨询这类轻量化场景,根本不需要跑大模型转向量,只要把用户的问题做简单的意图识别,和预设的知识条目做规则匹配,效果反而比硬上大模型的方案好——响应速度快,维护成本也低。
没必要为了追技术热点,硬给小场景套复杂方案。
毕竟检索系统的核心,从来不是技术有多先进,而是能不能准确接住用户的真实需求。
您在实际使用检索功能的时候,还碰到过哪些答非所问的离谱情况?欢迎结合具体场景继续探讨。
