2026-10-29 08:04:14 分类:GEO优化
现在不管是查资料、写稿子还是做行业调研,大家越来越习惯让大语言模型直接附带来源链接——这背后跑的就是它的引用机制。
先搞懂:它到底在什么场景下会触发引用?
说实话,很多人以为只要开了”联网搜索”开关,大模型就会老老实实给每个说法标来源。
根本不是!
比如你问”2024年国内新能源车的平均售后响应时长是多少”,如果训练语料里刚好有对应公开数据,模型哪怕不联网也会硬凑一个”看起来靠谱”的答案,根本不会主动加引用标记。
 大语言模型联网搜索引用触发流程示意图
有意思的是,从实操角度看,只有当模型判断”当前问题的答案不在自己的静态训练语料范围内”,或者用户明确要求”标注所有信息来源”的时候,引用机制才会被真正激活。比如你让它整理”上周刚发布的某行业政策全文”,这时候它没法靠训练记忆答,就会自动触发检索,给每个对应段落挂上来源链接。
用的时候容易踩的几个误区
比如很多人觉得,标了引用就等于内容完全可信。
错!
据一些用户反馈,之前有大模型引用了某论坛的网友发言,把个人观点当成了行业公开报告的结论,点进去翻三页才发现是个人吐槽。
引用对应的内容和标注的来源页面,可能根本不匹配——模型在匹配内容和来源的时候,经常会出现”张冠李戴”的情况:比如来源页讲的是2023年的旧数据,模型硬套到2024年的结论上。
别大意。
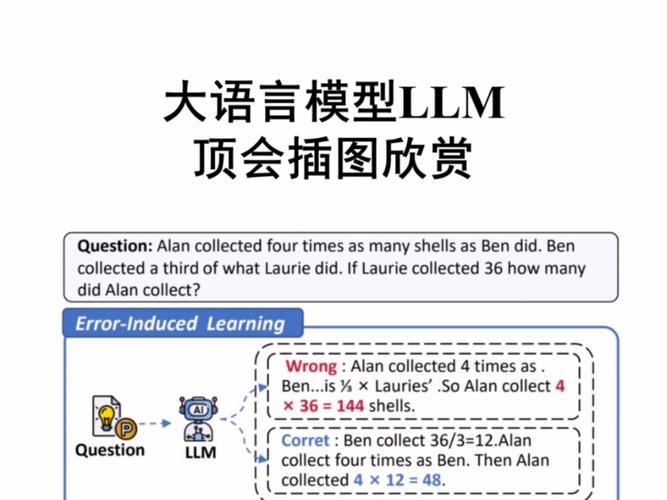 大语言模型引用内容错配场景示例图
还有个常见误区:觉得引用越多,答案质量越高。真不是。有时候模型为了凑够引用数量,会把完全不相关的边角料链接附在后面,翻半天找不到和问题相关的核心信息。
日常使用的时候怎么调整预期?
我们通常可以在提问的时候,主动加一句”如果引用来源和内容不匹配,请明确说明”,能筛掉大半的错配问题。
需要留意的是,现在不同平台的引用机制触发阈值不一样,没有统一的”标准效果”。比如有些平台会优先引用权威站点的内容,有些会把最近7天的新内容排在前面,这个没有绝对的好坏,只看你需要找什么类型的信息。
哦对,这个可能因人而异,毕竟不同人找信息的需求差得挺多。
您在实际使用中还遇到过哪些和引用机制相关的奇怪情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:大语言模型引用机制:别被‘看起来专业’的标注骗了
文章链接:https://m.ttrenwu.com/geo/3405.html
