2026-11-03 18:12:37 分类:GEO优化
你有没有过翻了几十G素材库,还是找不到想要的那段带猫的窗边视频的经历?现在的多模态内容检索,就是专门解决这类找内容难的问题的。
多模态检索到底解决什么实际问题
和传统的内容检索不同,它不需要你给每一张图、每一段视频提前打好精准的文字标签。举个例子,做课程剪辑的老师,要找一段“学生围在实验桌旁做物理电路实验”的素材,不用挨个点开几十个视频片段核对,直接把这段描述输进去,系统就能自动把匹配度高的视频、图片片段筛选出来。
真的省时间。
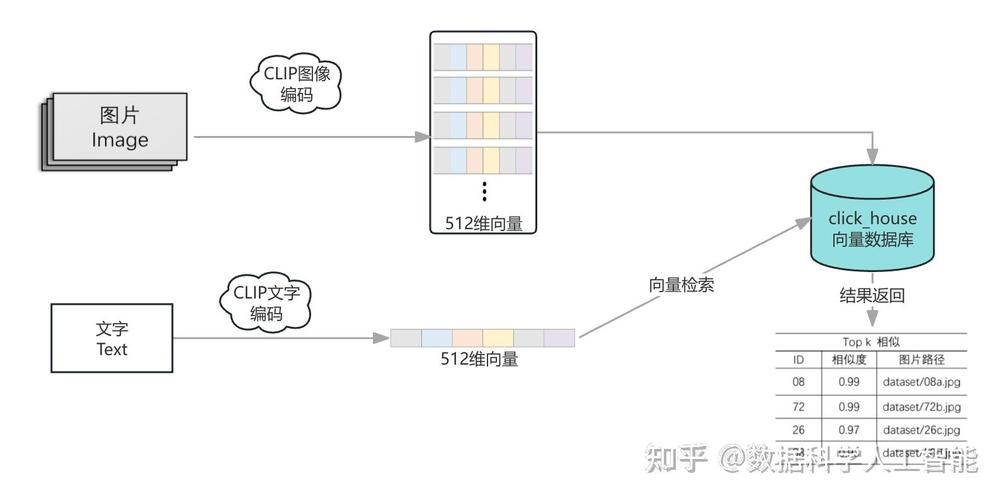 多模态内容检索跨模态匹配流程图
据一些用户反馈,之前翻素材库找内容的时间,能占到整个剪辑流程的3成以上,用上多模态检索之后,这部分时间能压到原来的1/5。
实操里容易踩的几个误区
很多人用的时候喜欢把检索词写得特别长,把时间、地点、人物的所有细节都堆进去,反而容易让系统抓不住核心特征,匹配准确率下降。
通常来说,只要把内容的核心视觉、听觉特征说清楚就够,不用加太多无关的限定词。还有个容易忽略的点,要是你的素材库体量超过1T,最好定期给特征向量做一次增量更新,不然新导入的内容很可能没法被检索到。
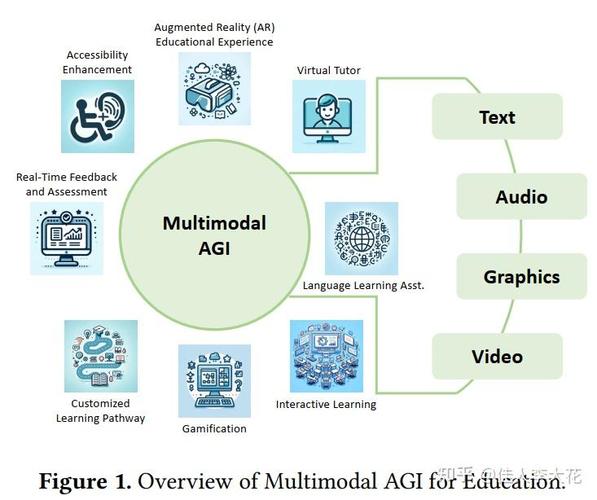 多模态检索常见输入输出场景对比图
和传统关键词检索的核心差别
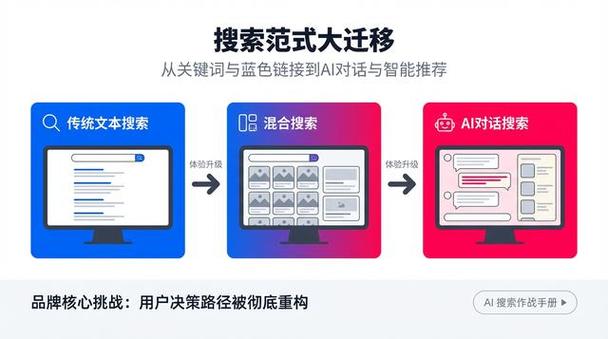 和传统关键词检索的核心差别
传统关键词检索的逻辑很直白,就是找标签和输入文字完全对上的内容,要是某张图片没人给它打“橘猫”的标签,你搜破头也找不到它。
多模态检索是把所有类型的内容,都转成同维度的特征向量做匹配,哪怕你上传的是一张随手拍的参考图,也能找到和这张图视觉风格、内容相似的其他素材。有意思的是,现在不少手机相册已经把这个功能做进去了,你不用记照片的拍摄时间,直接用文字描述,就能把对应的照片翻出来。
您在实际使用中还遇到过哪些检索不到目标内容的情况?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:多模态内容检索:找素材再也不用逐帧翻了
文章链接:https://m.ttrenwu.com/geo/3618.html
