多模态内容检索,说白了就是让文字、图片、音频、视频在一个池子里互相找。你手机相册里搜“猫”蹦出一堆照片,差不多的逻辑。别急着背定义。
多模态内容检索,通常用在哪些让人头疼的场景?
电商里找同款。拍一张鞋,上传,返回相似款。这背后不光是图片比对,还要把颜色、材质、风格这些文本标签和图像特征拉到同一个向量空间。有意思的是,有些平台连买家评论里的“偏大半码”都能关联到商品图。
再比如,设计团队要在几万条素材里找“黄昏海边、有帆船、冷色调”的视频片段。单纯靠文件名?基本废了。多模态检索可以把视频关键帧、音频转写、人工标签一起索引。据一些用户反馈,这种场景下检索耗时能从几小时压到几分钟——当然,前提是前期清洗做得不差。

还有安防、医疗、新闻归档。监控视频用自然语言搜“穿红衣服的人从左边跑过”,医疗影像报告里用文字找相似病灶,都是同类问题。不过话说回来,场景越专业,对标注和模型微调的要求就越高。
想自己搭一套?先留意这几个坑
别一上来就追求跨模态全能。先跑通单模态检索,比如以文搜图,或者以图搜图。再考虑音频、视频。很多团队栽在“大而全”上,结果连图片向量都搜不准。
模态对齐是硬骨头。文字“苹果”和图片里的苹果,在向量空间里可能离得远,因为文本模型见过太多“苹果公司”。你得用对比学习、双塔模型或者CLIP类架构做对齐。这个可能因人而异,但通常需要一批成对的图文数据。
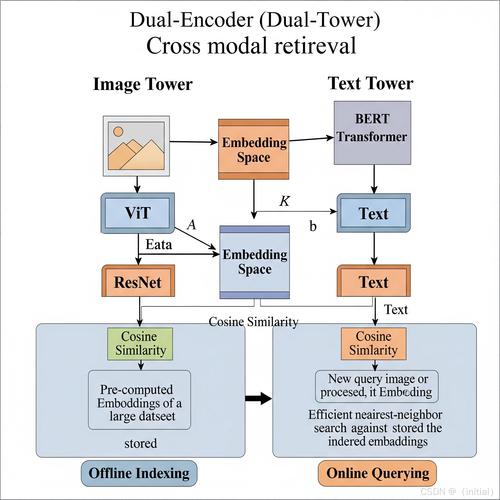
索引结构决定响应速度。数据量小的时候,暴力检索也能忍。上到百万级,就得用近似最近邻算法,比如HNSW、IVF。别忽略元数据过滤——用户搜“2023年夏天的红色裙子”,向量相似度之外,还得靠结构化字段筛掉一大批。
评估不能只看命中率。还要看召回、排序、延迟。从实操角度看,先定义20到50个真实查询,人工标注相关结果,再迭代模型和权重。否则容易自嗨。
成本容易被低估。存储向量倒还好,生成向量和微调模型才是大头。据公开报告,一些团队在POC阶段用开源模型,上线后换成商用API,费用结构会变。需要提前算账。
版权和隐私别装看不见。检索到别人的图片、视频,能不能展示?训练数据有没有授权?这些不是技术问题,但会决定项目能不能活。
多模态内容检索的底层,一般跑哪几步?

流程倒不复杂。第一步,把不同模态的数据转成向量。图片用视觉编码器,文本用语言模型,音频用声学模型。第二步,把这些向量塞进同一个索引。第三步,查询时也转成向量,做相似度计算。第四步,结合业务规则重排。说起来轻巧,做起来全是细节。
比如视频,你不能只抽一帧。关键帧、镜头边界、语音转写、字幕,都得分别处理再融合。否则搜“两个人吵架”可能返回一堆静止的风景。这个坑,不少团队踩过。
它和普通全文检索差在哪儿?

普通全文检索靠倒排索引,字面匹配强,但不懂语义。你搜“手机没电”,它不一定返回“充电宝”。多模态内容检索靠嵌入向量和跨模态映射,能处理“意思相近但字不同”的情况。
常见疑问:是不是必须用GPU?不一定。小规模demo用CPU加开源模型也能跑。数据量大了再考虑加速。另外,多模态检索不是替代传统搜索,两者经常混用:先用关键词粗筛,再用向量精排。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
