用户打的字,和心里想的常常对不上
搜“苹果”的人,可能想买手机,也可能想找水果批发。搜“Java”的人,可能问编程,也可能想喝咖啡。关键词检索会疯掉。语义检索与匹配做的事,说白了,就是猜意图。
它把词变成向量。听起来玄。其实像给每句话拍一张坐标照片。意思近的,坐标也近。比如“iPhone 电池不耐用”和“苹果手机续航差”,字面重合少,向量距离却可能很近。

注意,不是所有场景都适合一上来就上大模型。商品搜索里,型号、价格、库存这些硬条件,还是得靠过滤和倒排。语义层负责补召回。
向量、召回、重排:流水线怎么跑
我们通常可以拆成三步。先离线把文档切块、编码、建索引。再用 ANN 近似邻居搜索,快速捞出候选。到后来用交叉编码器重排。慢,但准一点。
举个客服知识库的例子。用户问“退款多久到账”,文档写的是“原路退回周期说明”。BM25 可能匹配不到。向量召回能抓住。可如果知识库里有“退款手续费”和“退款到账”,向量也可能混淆。所以混合检索比较稳:关键词保精确,语义保泛化。

从实操角度看,评估别只看准确率。要看 Recall@k、MRR,还有坏例。用户搜“儿童口罩 3岁”,你把成人口罩推上去,这就难受了。
几个容易踩的坑
领域漂移是个麻烦。通用模型在医疗、法律、工业零件里,可能把“苹果”和“梨”当近义。需要领域微调或加词典。
长尾查询更明显。低频词、错别字、拼音混输,向量训练不足时表现会飘。可以加拼写纠错、同义词扩展。别指望一个模型全包。
还有更新频率。商品下架、政策改版、FAQ 换答案,索引没跟上,语义匹配就越搜越错。维护周期因业务而异,通常按小时到天级别。
有意思的是,多语言场景下,跨语言向量有时能直接工作。比如中文 query 匹配英文 doc。但税务、法律术语,还是要人工校验。
它和关键词检索,边界在哪
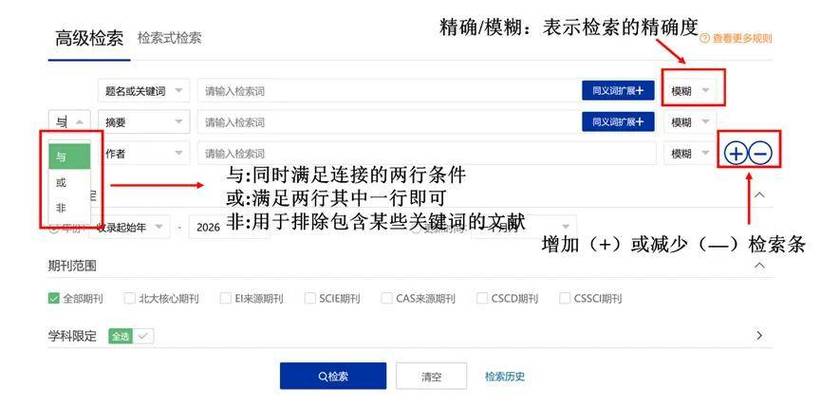
关键词检索像老实人。你写“蓝牙耳机 降噪”,它找字面。语义检索像会联想的同事。你写“地铁上听歌不想吵”,它也能猜。
据一些用户反馈,纯向量方案在电商搜索里容易召回太泛。加一层类目、品牌、价格约束,体感会好很多。这个可能因人而异,跟数据质量关系很大。
需要留意的是,语义检索与匹配不是替代关系。更像搭配。硬条件用规则,模糊意图用向量,排序阶段再融合。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
