知识图谱与实体识别:机器怎么从一堆乱糟糟的文字里认出人和关系
2026-11-20 14:56:08 分类:GEO优化
先聊聊机器怎么在一段话里“认出”人和地方
你给电脑一句话:张三上周从杭州飞到成都,找李四签了份合同。
人类扫一眼就明白,张三、李四是人名,杭州、成都是地名。机器不这么看。它看到的是字符、词组、上下文概率。实体识别干的事,说白了,就是把这串字符切出有意义的块,再贴上标签——这是人名,那是地点,那个是机构。
听着简单,做起来烦。
 命名实体识别NER文本标注流程示意图
比如“苹果”两个字。是水果?是公司?还是某个手机品牌?单看这个词,机器没法判断。得看上下文。“苹果今年收成不错”和“苹果发布了新系统”,指向完全不同的实体类型。所以实体识别很少孤立工作,它依赖上下文、依赖领域词典,有时候还得依赖一点点运气——真实语料里脏数据太多了。
说实话,做过标注的人都知道,这个环节能把人逼疯。边界在哪儿?“北京大学第三医院”算一个机构实体,还是拆成“北京大学”和“第三医院”?不同标准,不同结果。这个可能因人而异,也因项目而异。
实体识别出来了,然后呢
一堆散落的实体,像一桌子没拼好的拼图。单看都有意义,放一起却连不起来。
知识图谱做的,就是把这些实体和它们之间的关系串成一张网。张三——任职于——某公司。某公司——位于——杭州。杭州——属于——浙江省。节点是实体,边是关系。这样一来,机器不只知道“张三”是个名字,还知道他跟谁有关系、在哪儿、干什么。
这就有点意思了。
搜东西、看推荐、找客服,背后多少都在用这套东西。你问一句“张三是哪家公司的”,如果图谱里存了这条边,系统直接查边就能答,不用去读完整篇文章。
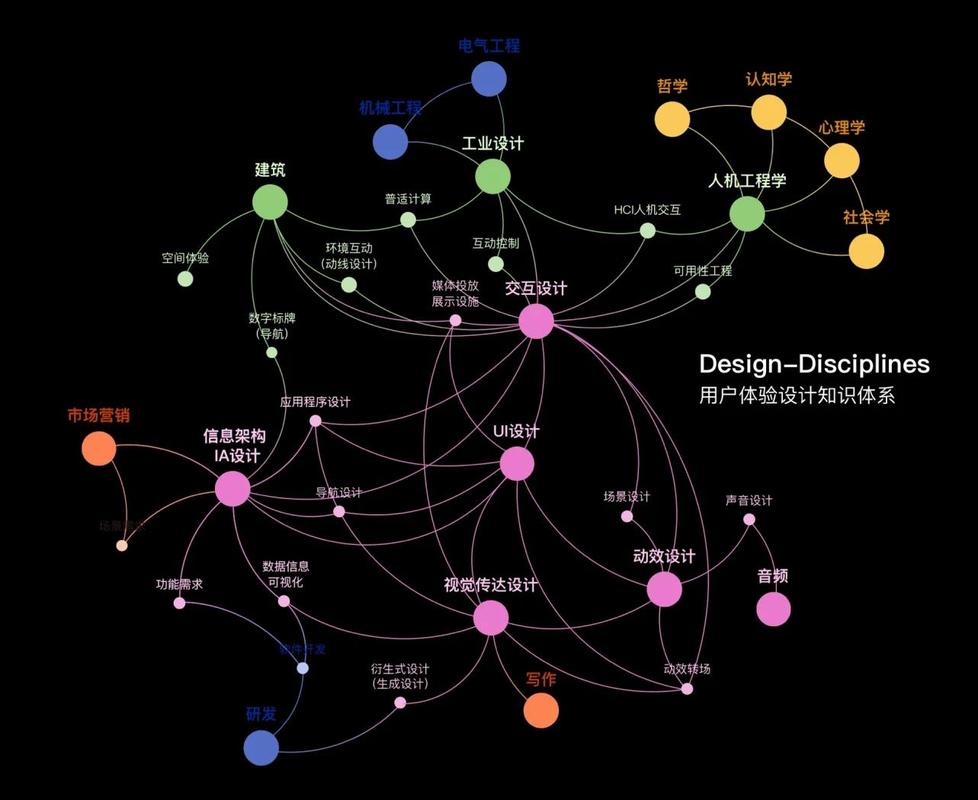 知识图谱实体关系网络可视化结构示意图
从实操角度看,图谱的难点不在建,在维护。数据会变。张三跳槽了,公司改名了,地址搬迁了。图谱里的旧边就成了噪音。怎么更新?多久更新一次?要不要人工审核?这些没有统一答案。行业里比较常见的做法是混着来——机器批量抽,关键节点人工兜底。纯自动更新容易累积错误,纯人工又扛不住规模。
几个容易踩的坑,绕开走
有人以为,实体识别准确率高,图谱质量就高。不一定。识别对了,关系抽错了,图谱照样废。
还有人忽略实体对齐。同一个东西,在不同数据源里叫法五花八门。“阿里巴巴”、“阿里”、“Alibaba Group”,不归一化,图谱里就冒出三个节点,关系全断。这个问题挺隐蔽,前期不容易发现,等到查询对不上号才拍大腿。
另外,别迷信“全自动”。据一些用户反馈,完全依赖大模型做端到端抽取,早期省事,后期排查错误会很痛苦——你压根不知道它为什么这么抽。留个可解释的中间层,标注、规则、词典,反而让后续维护轻松点。
需要留意的是,知识图谱不是建完就一劳永逸的资产。它更像一个需要持续喂养的系统。喂得好,越用越顺;断了粮,慢慢就烂了。
它和大模型、搜索又是什么关系
 它和大模型、搜索又是什么关系
有人问,现在大模型这么强,知识图谱还有用吗?
有用,只是角色变了。大模型擅长理解和生成语言,可它的知识藏在参数里,改起来费劲,还容易一本正经地胡说。知识图谱把事实显式存着,可查、可改、可追溯。两者搭起来,一个负责理解问题,一个负责提供相对可靠的事实,配合起来比较顺手。
检索增强生成,也就是常说的RAG,很多时候就是让大模型去查图谱或者向量库,再组织答案。
当然,这不是万能药。图谱覆盖不到的领域,模型还是得靠自己那点参数知识撑着。边界在哪儿,得看具体场景,没有标准答案。
您在实际做项目时,实体对齐和关系更新这两步,哪一步更让您头疼?欢迎结合具体场景继续聊。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:知识图谱与实体识别:机器怎么从一堆乱糟糟的文字里认出人和关系
文章链接:https://m.ttrenwu.com/geo/4253.html
