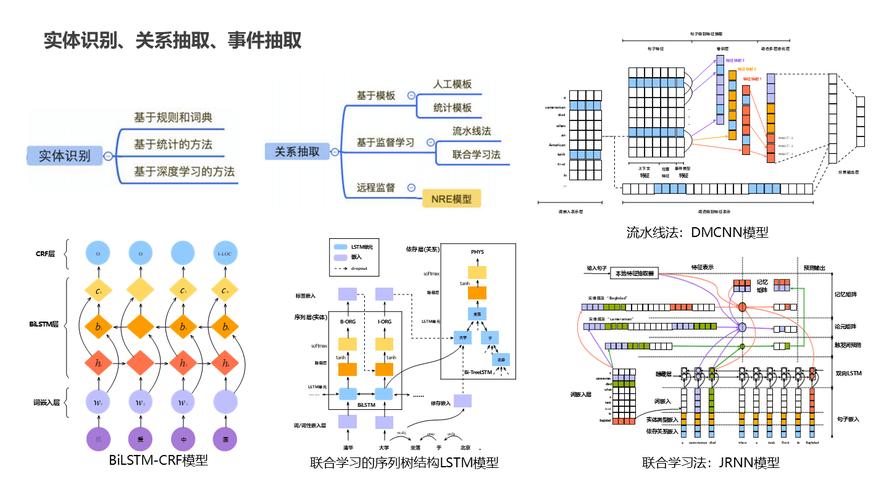
知识图谱这东西,很多人把它想得太重了。它就是一张网。结是实体,线是关系。真正的麻烦事在哪儿?在这张网搭起来之前——你得先从一堆脏兮兮的文本里,把“谁”“在哪”“干了啥”给揪出来。这一步,叫实体识别。
实体识别到底在认什么
名字起得挺学术:命名实体识别,NER。干的活儿其实很土。给一段话,标出里面的人名、地名、机构名、时间、金额、产品型号……就这些。
举个例子。客服系统里蹦出来一句:“我上个月在朝阳大悦城买的那副耳机左耳没声了。”人眼看,一秒就懂。机器看,得先切出:上个月(时间)、朝阳大悦城(地点)、耳机(商品)。缺一个,工单就可能流转错。
有意思的是,中文的实体识别比英文费劲。没有空格分词,边界模糊,简称、别称满天飞。“北医三院”和“北京大学第三医院”是同一个东西吗?机器不知道,得靠词典加上下文慢慢磨。

图谱那头,真正头疼的是“对不上号”

实体抽出来了,接下来要让它们进图谱。这里才是泥潭。
同一个实体,写法能有七八种。“张三”“张先生”“老张”“Zhang San”——都是一个人。反过来更坑:一个词对应好几个东西。“苹果”是水果,也是公司。“小米”是粮食,也是手机品牌。这活儿有个行话,叫实体消歧,或者实体链接。
从实操角度看,这一步的准确率往往决定整张图谱能不能用。抽错一个词,顶多丢条数据;链接错一个实体,整条关系链都跟着歪。据一些用户反馈,项目里花在“清洗和对齐”上的时间,通常比建模本身多得多。挺无奈的,但这就是现实。
想少踩坑,几个点提前想清楚
别一上来就画大 schema。不少人兴致勃勃设计了上百个实体类型、几十种关系,结果数据一灌进去,发现一半字段根本填不满。空图谱看着整齐,其实没什么用。
从一个小而垂直的领域起步。比如只做某类设备说明书的知识抽取,先把实体类型收敛到十来个。跑通了,再往外扩。这个可能因人而异,但小步快跑一般比大规划活得久。
留一条人工校验的口子。自动抽取的召回率再高,也会漏。让业务方能在界面上改、补、合并,这事看着土,长期价值不小。
评测别只盯一个数。准确率和召回率是两回事。医疗、金融这类场景,通常更怕错,宁可漏一点,也别把错的写进图谱里,后面很难回头清理。
它跟现在流行的向量检索,是啥关系

问的人挺多。简单说:向量检索擅长“找相似”,图谱擅长“走关系”。你问“A公司的母公司旗下还有哪些品牌”,向量库大概会丢给你一堆看着像的段落。知识图谱能沿着边一步步走过去,把答案拼出来。
两者不打架。近些年常被放在一起用,也就是大家说的 GraphRAG 之类的路子——先用图谱框定范围,再用向量做语义匹配,中间那层实体对齐做得糙,效果就打折扣了。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
