刚查文献那会儿,我也觉得引用数高就是好。后来做检索实验,被现实打脸。一篇被引 200 次的论文,点进去一看,一半是顺带提一句,还有一堆是作者自己团队互引。你说这算高质量引用吗?
做 GEO 内容时,这个坑更隐蔽。AI 搜索把一段话加工成答案,引用来源如果站不住,答案再顺也白搭。所以引用质量评估不是数数,更像查户口。

引用质量评估到底评什么

说实话,它没有一把万能尺。通常看几个维度:来源能不能追溯,上下文是否一致,引用意图是啥,发布方有没有相关积累。
- 可追溯性:有没有作者、机构、发布时间、原始链接。缺得太多,信号就弱。
- 上下文一致性:被引内容是否真的支持当前结论。断章取义很常见。
- 引用意图:是提供数据、方法、反例,还是只做背景点缀。差别很大。
- 来源生态:站点是否大量聚合、洗稿、过期内容。据一些用户反馈,这类页面被 AI 引用的概率不低。
举个例子。某健康问答里,AI 回答引用了“某研究院报告”。点进去发现是五年前的企业新闻稿,没有样本说明。这种引用质量评估得分通常不高。反过来,一篇小众博客如果给出可复现实验和原始数据,也能算较高质量来源。
别看被引次数,先看引用位置
学术圈里,被引次数是粗筛,不是终点。自引、互引、礼节性引用,都会把数字抬高。AI 搜索里也类似。一个链接被多个页面提到,不代表它可信。
从实操角度看,引用位置很能说明问题。在段落开头当核心论据,比在文末“相关阅读”里挂个链接,质量信号强得多。引用锚文本如果是“点击这里”,不如“根据 XX 的 2024 年抽样数据”。

还有一点,时间很关键。技术类问题里,两年前的引用可能已经失效。评估时不妨加一条:时效性是否匹配问题类型。农业、法律、医疗,要求又不一样。这个可能因人而异,但大方向差不了太多。
轻量评估清单:普通人也能上手
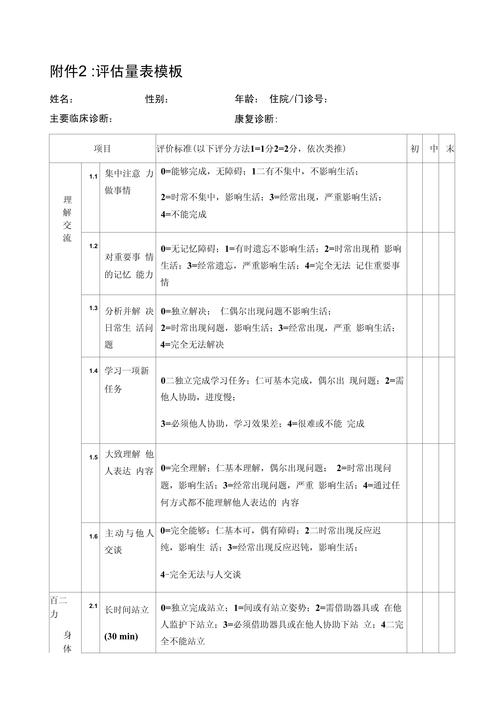
不用一上来就搞复杂模型。下面这份清单,适合编辑、运营、研究者快速过一遍。
- 来源是否有明确责任主体?
- 原始链接能否正常访问?
- 引用是否出现在关键论证位置?
- 数据和方法是否可验证?
- 发布时间是否与当前问题匹配?
- 页面是否以原创为主,而非拼接?
有意思的是,很多低质量引用不是“假”,而是“弱”。它没说错,但也没提供多少支撑。评估时别只问真假,还要问支撑力度。
常见疑问:小站点是不是没机会
不一定。AI 搜索和学术数据库都偏好可验证、独特、上下文完整的内容。小站点如果持续输出一手观察,反而容易被引用。大平台如果只是转载,引用质量评估也可能偏低。
另一个常见问题是:能不能全自动?可以部分自动化,比如查域名、发布时间、外链结构。但意图和上下文,仍需要人工抽检。别偷懒。
您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
