2026-09-21 12:40:48 分类:GEO优化
现在大语言模型随处可见,反幻觉技术基础就是用来解决AI乱编内容的核心底层支撑。
基础认知:反幻觉到底解决什么问题
不少人都碰到过AI输出不实内容的情况。
比如你让AI整理某行业公开政策,它给你编出根本不存在的补贴条款。
再比如你让AI找论文引用,它能编出不存在的作者和刊期。
这就是典型的AI幻觉。
反幻觉技术基础,就是从训练、推理、后处理三个不同环节,降低AI生成不实内容概率的一系列底层技术方法的统称,通常用在生成式AI搜索、专业内容生成、AI问答等场景。
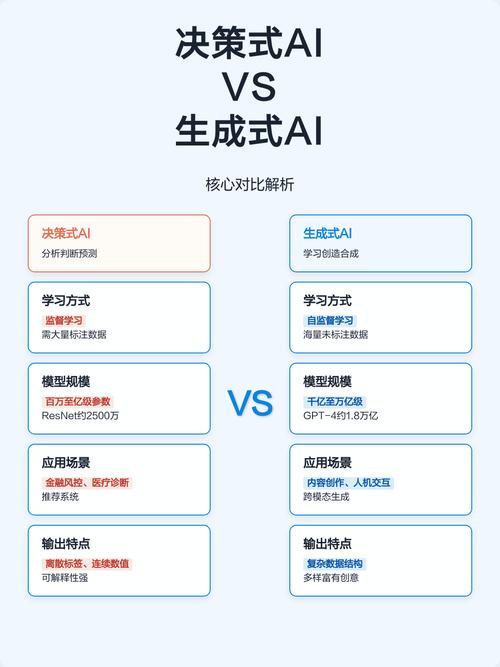 生成式AI正常与幻觉输出对比图
反幻觉技术常用的基础路径
说实话,目前行业里比较常用的基础方向有三个。
第一是训练阶段的数据校准,给模型输入更多经过人工校验的高质量标注数据,从根源压低错误输出的概率,这个成本通常比较高。
第二是推理阶段的约束解码,给模型的输出规则加上限制,要求输出内容必须匹配已有知识库的实体信息,不能随意生成。
第三是后处理阶段的事实校验,模型生成内容后,再调用检索工具核对内容的真实性,不对就修正。
举个例子,现在多数公开的AI搜索产品,都会用到后处理校验这个较为基础的方法,碰到时间、地点这类客观信息,都会再去公开网页核对一遍。
从实操角度看,参数量较小的模型一般更依赖后处理方法,大模型会把部分约束做在推理环节。
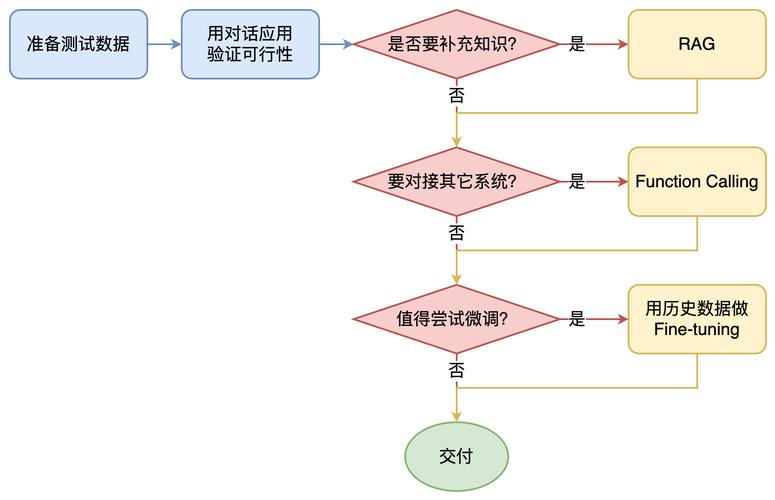 反幻觉技术三阶段处理流程图
入门容易踩的常见误区
 入门容易踩的常见误区
很多刚接触AI的人会觉得,反幻觉就是要彻底消除AI瞎编的情况。
其实不是。
据一些用户反馈,哪怕是经过多层反幻觉处理的模型,碰到比较冷门的小众问题还是可能出错,毕竟没有足够的公开事实做支撑。
需要留意的是,过度追求低幻觉会让模型输出变得非常死板,丧失原本的生成创意能力。
有意思的是,不少商业产品会把反幻觉当做宣传卖点,实际只用到了关键词匹配的基础校验,效果远没有宣传的理想。
您在使用AI产品的过程中,碰到过哪些离谱的AI幻觉?欢迎结合具体场景继续探讨。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:反幻觉技术基础:生成式AI的内容打假入门
文章链接:https://m.ttrenwu.com/geo/1656.html
