基础认知:两者到底在日常里做什么
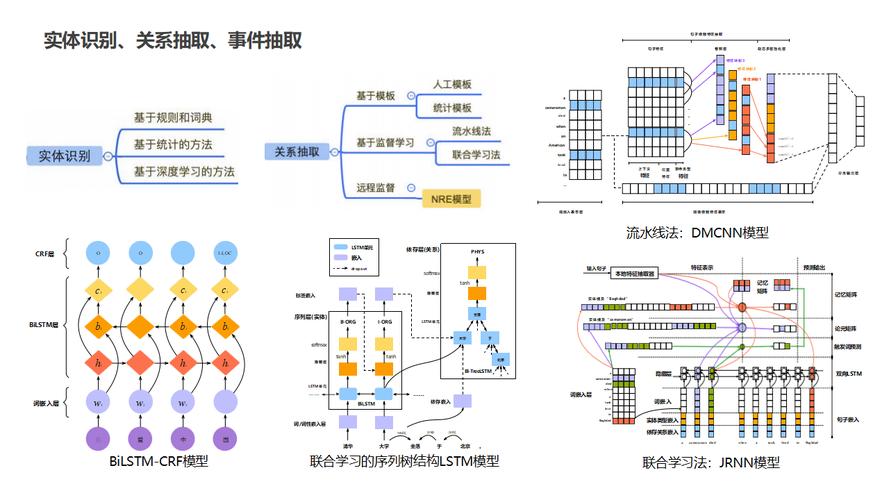
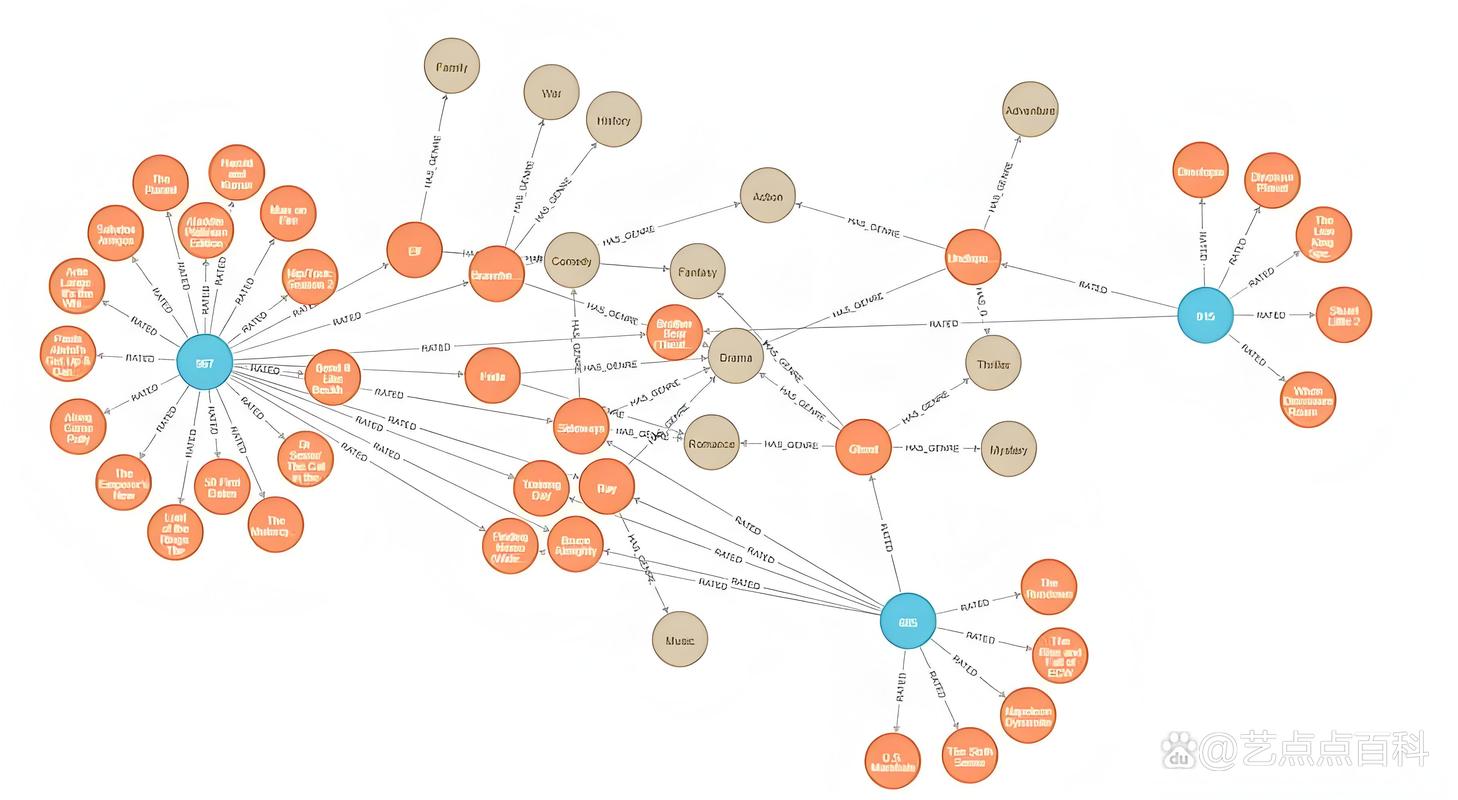
简单说,知识图谱就是把零散信息按关系织成一张网,实体识别是构建知识图谱的第一步,负责从杂乱的文本里把带明确含义的主体挑出来分类。
举个例子,你在社交平台发一句“昨天去上海迪士尼玩了创极速光轮”,实体识别会自动把“上海迪士尼”(地点)、“创极速光轮”(游乐项目)这两个核心实体提取出来,知识图谱再顺着实体关联出门票价格、附近酒店、项目排队时长这类信息,推给感兴趣的人。
实际落地要留意的常见误区
说实话,很多刚接触的朋友容易踩同一个坑:直接拿通用预训练模型往细分场景套。
据一些用户反馈,做法律文书知识图谱的时候,用通用模型只能识别出“人名”“机构名”,没法提取出“法条”“罪名”这类细分实体,结果后续整个图谱的关系全错,还得返工重新标注数据。
需要留意的是,实体识别的准确率直接决定知识图谱的可用性,错认一个实体,整条关联关系都会歪掉。从实操角度看,就算用现成模型,也得抽十分之一左右的场景数据做微调,结果才够用。
延伸视角:别把技术想得太遥不可及
有意思的是,现在不少中小项目不需要从零搭一套完整的知识图谱与实体识别系统,很多云服务厂商都提供现成的接口,按调用量付费就行,成本比自己养团队低很多。
这个可能因人而异,如果只是小体量的结构化整理需求,用现成接口完全能满足,不用一味追求自研。
您在实际接触知识图谱与实体识别的过程中,还碰到过哪些具体问题?欢迎结合自身场景继续探讨。
