2026-10-22 17:21:22 分类:GEO优化
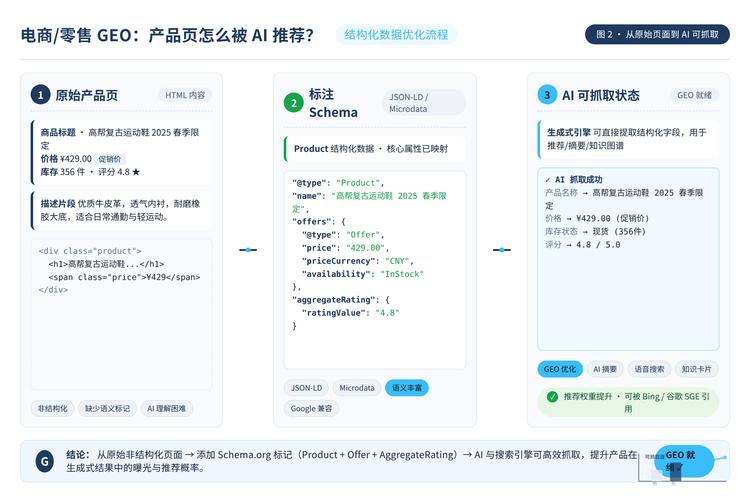
不管是训练垂直领域的AI模型做语义识别,还是让自家网站内容在搜索结果里拿到更醒目的展示位,结构化数据标注都是绕不开的基础动作。
先搞懂:它和普通打标签的核心差异
很多人一听到标注,第一反应就是给图片、文字随便贴个分类标签。
不对。
结构化数据标注的核心,是给所有待处理的信息打上**统一格式、语义明确的标记**,不管是AI训练模型,还是搜索引擎这类机器系统,都能精准读懂标记背后的固定含义,不会出现理解偏差。
举个很生活化的例子:我们平时搜“番茄炒蛋做法”的时候,搜索结果里直接弹出来的食材用量、烹饪总时长、适合的食用人数,就是网站提前做了结构化数据标注的效果。要是只做普通的文字标签,搜索引擎根本没法把这些结构化的信息直接提取出来展示。
 搜索结果结构化数据展示示例
从实操角度看,标注的格式统一度,直接决定了后续数据能不能直接投入使用。差一点都可能出现识别错位,比如给一张宠物照片标注时,只随便写个“猫”,那是普通标签;但如果按照统一规范,标记清楚“物种:短毛猫,品种:英短,毛色:蓝灰色,动作:卧在布艺沙发上”,这才是能直接用的结构化标注。
实操里容易踩的几个常见误区
别等标了几千条数据才回头改规则。
很多团队启动标注项目时,觉得规则差不多就行,先让大家开始标,做一半才发现分类逻辑有漏洞——比如做健康内容的标注,一开始没明确“普通感冒”和“病毒性上呼吸道感染”算不算同一个分类,最后标出来的数据一半归到A类一半归到B类,后续清洗要花好几倍的时间。说白了,**标注规范的前置对齐**,比后续补做数据清洗要省太多成本。
要提前把边界场景的判定规则写死。
比如给自动驾驶的路面图像做标注,遇到站在斑马线边缘、没迈步的行人,算不算“正在横穿马路”?这类模棱两可的情况,要是让标注人员自己拿主意,最后出来的数据标准根本没法统一。
据一些用户反馈,要是不做定期的标注质量抽检,很容易出现后期标注质量下滑的情况。毕竟连续做几小时重复的标注工作,人很容易疲劳,出现随便打标签凑数的情况,最后整体数据的准确率会掉得很明显。**定期的标注质量抽检**,是保障标注数据可用性的关键环节。
 结构化数据标注项目规范文档页面
容易和它混淆的几个相邻概念
 容易和它混淆的几个相邻概念
很多人会把结构化数据标注和自媒体的内容标签搞混。
其实差异很明显:自媒体给文章打的“#露营”“#手作”这类标签,是给普通读者看的,没有统一的语义标准,不同人对“精致露营”和“普通野餐”的定义可能差很多;但结构化数据标注是给机器读的,有公开通用的规范可以遵循,比如Schema.org里针对菜品、视频、本地商家的标注格式,就是行业里较为通用的参考标准。
还有人会把结构化数据标注和全量数据标注划等号。其实根据不同的项目需求,通常不需要给所有数据都做精细化的结构化标记,比如做网站SEO的结构化标注时,只要给核心的产品页、文章页、商家信息页做对应标记,就能拿到基础的展示效果,没必要给所有页面都做冗余标注。
您在实际开展结构化数据标注工作时,还遇到过哪些具体的难题?欢迎结合实际场景继续交流。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:结构化数据标注:实操避坑与认知参考
文章链接:https://m.ttrenwu.com/geo/3142.html
