刷到一篇讲”苹果发布新系统”的文章,你知道这里的苹果是科技公司还是水果?
实体链接与消歧干的就是把这类模糊表述精准对应到真实存在对象的活儿。
别觉得这事儿简单。真的。
日常场景里的实体链接与消歧
我们平时用的搜索、智能推荐、知识图谱搭建,背后全靠这套技术托底。
举个常见的例子。用户在本地生活平台搜”去西湖边的外婆家吃饭”,系统不能把”西湖”匹配到全国二十多个同名的景点,也不能把”外婆家”当成用户亲戚家的住宅。
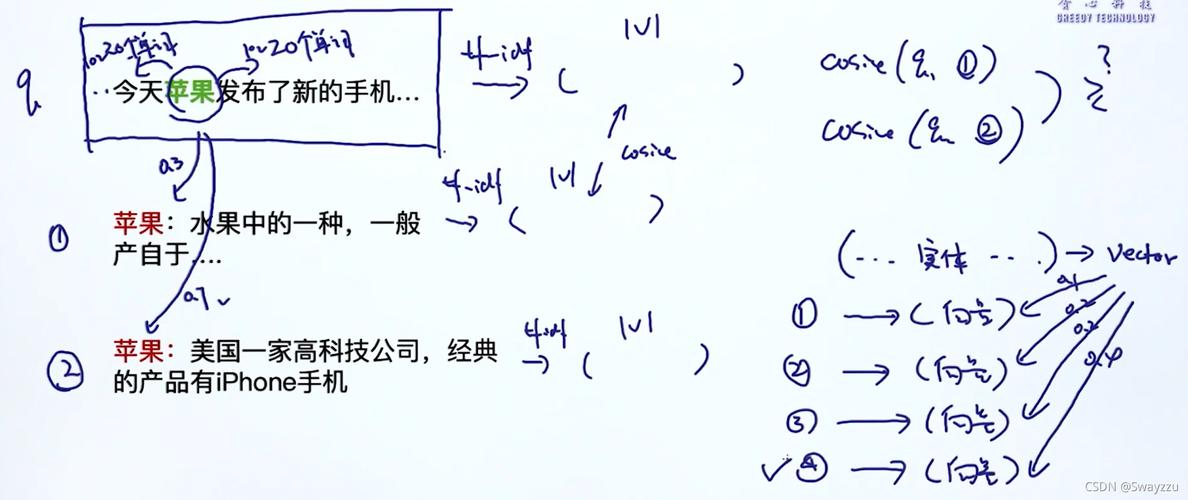
有意思的是,很多人第一次接触这套技术的时候,会觉得不就是个字符串匹配?真上手就知道差远了。
你对着智能助手说”放周杰伦的晴天”,系统不会把”晴天”匹配成天气预报里的天气状况,靠的就是上下文语境的判断,不是硬套关键词。
实操里容易踩的几个坑
据一些用户反馈,很多初期搭建实体链接系统的团队,会把多义实体的判断阈值设得太宽,结果错漏百出。比如碰到文本里同时出现”手机””芯片”这类词汇,本来应该把”苹果”匹配到科技企业,结果因为阈值太低,经常错分到水果类目。
还有个常见误区。不少团队觉得有了通用大模型的内置实体库就万事大吉,碰到垂直领域的小众实体——比如本地开了十几年的独立书店、行业内的专属产品代号——通用库根本没有收录,最后识别出来的结果和实际情况差得很远。
说真的,这种错得特别让人哭笑不得。之前碰到过一个案例,系统把某篇行业报道里的”字节”,因为上下文没提互联网相关的词,直接匹配成了物理单位的字节,闹了不小的笑话。
和相近概念的边界
很多人会把实体链接与消歧和命名实体识别(NER)搞混。
其实两者差了关键一步。NER的工作只是把文本里的”人名、地名、机构名”这类片段从段落里标出来,比如识别出”张三”是个人名。但这个张三到底是你公司的产品经理,还是同名的旅行博主?这部分精准锚定到对应真实对象的环节,就是实体链接与消歧要完成的。
从实操角度看,不少团队一开始只做NER就急着上线,结果信息抽取的准确率一直上不去,就是缺了后面的消歧校验环节。
现在不少行业已经开始把自定义实体库和大模型的语义理解能力结合,降低多义实体的错判率。
您在实际使用中还遇到过哪些消歧失败的有意思的情况?欢迎结合具体场景继续探讨。
