搜图、搜视频、搜音频,背后是一套向量游戏
你输入“猫咪在键盘上打滚”,出来的不只是标题带这几个字的图片。系统会把文字、图片、音频、视频分别编码成向量,然后算距离。听着玄,用起来挺直接。
我早先试多模态内容检索,是在一个素材库里找“傍晚,便利店门口,胶片感”。以前得翻半小时标签。那次几秒就出了候选。有点惊喜。也有点懵——它怎么知道我要的是那种偏青的色调?
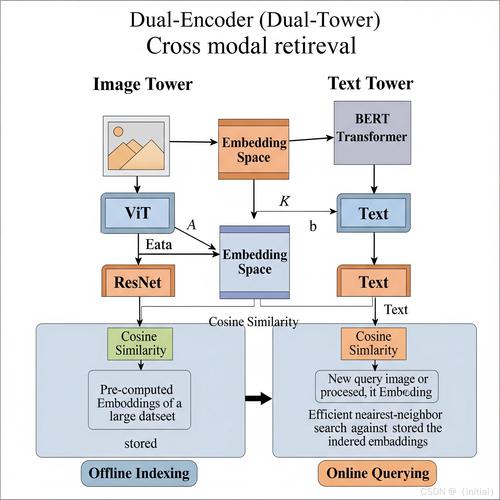
跨模态对齐是核心。文本编码器和图像编码器,要在同一空间里说同一种“语义方言”。否则文字说“萌”,图片理解成“毛绒”,距离就远了。另一个关键是粒度。整张图一个向量,搜细节往往吃亏。切成区域、物体、甚至字幕片段,召回才更细。
落地时容易踩的坑,比模型选型更烦人
说实话,很多项目卡住,不是因为模型不够大,而是数据太乱。图片没有元数据,视频没有时间戳,音频没有转写。你让检索系统怎么办?硬搜。结果就是召回一堆,精准度感人。
从实操角度看,先别急着上大模型。把素材的基础元数据补齐:来源、时间、地点、人物、版权、标签。再把非文本内容转成可检索文本,比如语音转写、视频关键帧描述、图片OCR。这些活很土,但管用。

需要注意权限和版权。检索结果能看,不代表能下载、能商用。尤其企业知识库,多模态内容里常混着合同截图、会议白板、客户照片。权限过滤要在检索层做,不能等结果出来再删。这个坑,不少团队踩过。
和传统搜索、标签搜索怎么配合
多模态检索不是把关键词搜索干掉。更常见的做法是混合:关键词召回保底,向量召回扩语义,然后用重排模型把更相关的顶上来。用户搜“发布会 手机 黑色”,标签能筛品牌,向量能找相似外观,重排看场景匹配度。
比如电商以图搜商品。用户拍一张街拍,想找同款外套。纯图搜可能找到版型像但材质不同的。加上文字“羊毛 短款 通勤”,结果会稳一些。据一些用户反馈,混合检索的点击率通常比单路检索好。当然,这个因品类而异。
常见疑问:能不能直接替代人工标注?

短期看,不能。自动打标省事,但会漏掉长尾、反讽、行业黑话。医疗影像、工业质检这类场景,误判成本高,人工复核仍常见。另一个疑问是更新频率。新内容进来,向量库要增量更新。全量重建费时,增量策略和版本管理得提前想。
还有评估。别只看“搜到了没”。要看前几条结果的相关性、多样性、时效性。A/B 测试比拍脑袋靠谱。维护周期嘛,通常按月看召回,按季度看模型和索引策略。业务变化快,就再缩短。
您在实际使用多模态内容检索时,还遇到过哪些奇怪结果?欢迎结合具体场景继续聊。
