前两天朋友问我,为啥现在搜东西,AI直接给答案,而不是一堆链接?我愣了一下——这问题背后,其实就是生成式AI搜索原理在起作用。说实话,这东西没那么神秘,但也没那么简单。
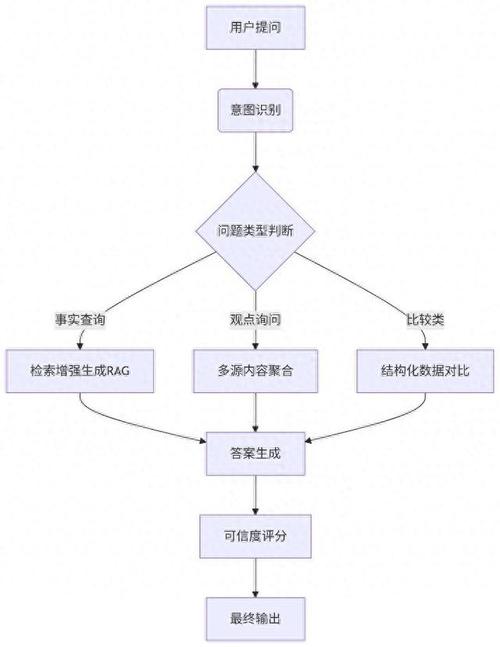
它到底怎么工作的?先搞懂“检索”这一步
传统搜索,比如你搜“红烧肉怎么做”,它给你十条链接,你自己点进去看。生成式AI搜索呢?它直接给你一段步骤,甚至告诉你放多少糖。这中间发生了什么?
简单说,它先理解你的问题。注意,是理解,不是匹配关键词。然后它去“找资料”——从预先建好的索引里,或者实时从网上抓取。最后,它把找到的信息“揉”成一段通顺的话。这个过程,行业内常叫RAG,检索增强生成。
有意思的是,它找资料的方式和以前不一样。以前是关键词匹配,现在是语义匹配。比如你搜“苹果好吃吗”,它知道你可能在说水果,而不是手机公司。怎么做到的?靠向量。
嵌入模型,你可以理解成一个翻译器。它把一段文字变成一串数字,比如[0.2, -0.5, 0.8, …]。这串数字代表了这句话的意思。意思相近的句子,数字串也相近。据一些公开资料,这种表示方式能捕捉到上下文和语义。
然后这些数字串存到向量数据库里。当你提问时,你的问题也被转成数字串,然后数据库找比较接近的那些数字串,对应的原文就出来了。这个过程叫相似度搜索。通常用余弦相似度或者点积来衡量。

不过话说回来,找出来的资料不一定都对。有时候会找到过时的,或者相互矛盾的。所以生成式AI搜索还需要一个步骤:重排序。把比较相关、比较可信的排在前面。这个环节,不同系统做法不一样。有的用交叉编码器,有的用规则。
生成答案:大模型在“编”还是在“总结”?
资料找齐了,接下来就是大语言模型出场。它把问题和资料一起读进去,然后一个字一个字地往外“吐”答案。注意,它不是在复制粘贴,而是在“改写”。它会综合多份资料,用通顺的语言表达出来。
但是——这里有个但是——它可能会“幻觉”。也就是编造一些资料里没有的内容。比如你问一个冷门历史事件,它可能把两个事件混在一起。从实操角度看,这是目前生成式AI搜索比较常见的问题。所以很多产品会标注引用来源,让你自己去核对。
另外,它的答案质量很依赖你问的问题。你问得越具体,它答得越准。你问“推荐个手机”,它可能泛泛而谈;你问“3000元以内,拍照好的手机,不要曲面屏”,它给出的答案就靠谱多了。
还有一点,不同AI搜索产品的“性格”不一样。有的偏向保守,只从资料里摘;有的偏向发散,会加入自己的推理。这个可能因人而异,看你喜欢哪种。
这对我们搜东西、做内容有什么启发?
搜东西更省事了,不用点开一堆网页,直接看总结。但也要留个心眼,特别是涉及医疗、法律、金融这些领域,建议再查证一下。毕竟AI不是神,它也会错。
做内容的人要注意了。以前SEO盯着关键词,现在得盯着语义。你的内容能不能被向量模型“理解”成相关,很重要。比如你写一篇关于“生成式AI搜索原理”的文章,光堆关键词没用,得把概念讲透,让模型觉得你专业。
另外,内容的结构也很关键。模型喜欢清晰的段落、小标题、列表。你写得越有条理,它越容易提取关键信息。据一些用户反馈,那些有明确问答格式的页面,被AI引用的概率更高。
常见疑问:它和传统搜索到底差在哪?

传统搜索给你一堆链接,你自己筛选。生成式AI搜索给你一个整合后的答案,但你可能不知道它从哪来的。这是一个明显的区别。也是为什么有些人不信任它——因为看不到“证据”。
从技术角度看,生成式AI搜索并没有完全取代传统搜索。很多时候,它背后还是依赖传统搜索的索引。只是它把“找”和“说”合并了。未来可能会更智能,比如多轮对话、多模态搜索(图片、视频)。
有意思的是,现在有些工具让你自己选:要简洁答案,还是要来源列表。我觉得这个方向挺好,把控制权还给用户。您在实际使用中还遇到过哪些情况?欢迎结合具体场景继续探讨。
