你敲一句“昨天那个新闻到底怎么回事”,它没甩给你十条蓝色链接。它直接给了一段话,还带几个小角标。怪不怪?这就是生成式AI搜索在干活。它不像老式搜索那样只匹配关键词。它更像一个急性子的实习生——先猜你想问什么,再翻资料,再当场写摘要。

它先干的事:把你的问题“掰开揉碎”
传统搜索拿你的词去倒排索引里撞。生成式AI搜索不一样。它会把 query 改写成好几个版本。比如你问“带三岁娃去北京周边露营,周末,别太累”,模型可能拆成:亲子露营地、车程两小时内、可租装备、卫生间条件、近期评价。对吧,这一步叫查询重写或者意图扩展。
有意思的是,它还会猜你没说的条件。你只说“别太累”,它可能补上“少爬山”“有接驳车”。猜错了怎么办?好的系统会保留原 query 的检索结果,再把扩展结果混进去。不会全押在猜测上。
从实操角度看,这一步挺像给搜索引擎递了一张小抄。小抄写得好,后面召回就准。写得飘,后面全歪。
检索层:向量、关键词,两条腿走路
生成式AI搜索原理里,检索是地基。很多系统用混合检索:一路是稀疏检索,比如 BM25,盯着词频和逆文档频率;另一路是稠密检索,用嵌入模型把文档切块,变成向量,塞进向量库。
为什么两条腿?因为关键词匹配擅长精确命中,比如型号、人名、法规编号。向量检索擅长语义,比如“心累”和“职业倦怠”可能挨得近。只靠一边,容易瘸。
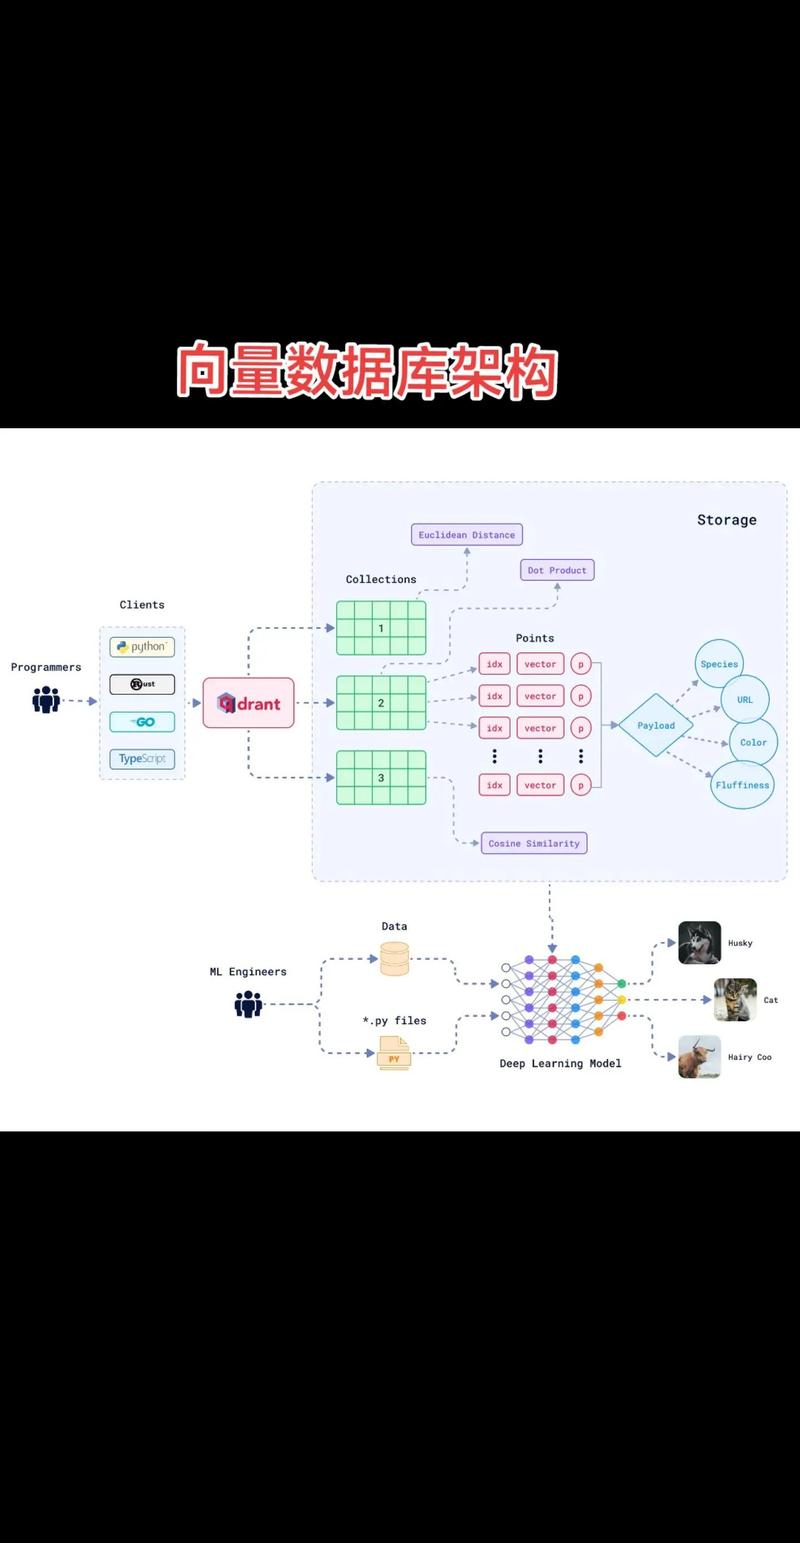
文档不会整篇扔进去。通常要切 chunk。一个 chunk 大概几百 token,可能带一点重叠。重叠是为了别把一句话拦腰砍断。不过切太碎,上下文丢了;切太大,噪声又混进来。这个尺寸没有万能答案,得看语料和问题类型。
向量库一般用 ANN 近似最近邻来找相似块。HNSW、IVF 这些索引结构,公开资料里常见。它不保证每次找到全局精确的邻居,但换速度。搜索场景里,延迟往往比理论完美更要命。
重排、生成、引用:别让模型自由发挥
召回几十上百个片段后,不会一股脑塞给大模型。先重排。交叉编码器或者小模型给每个片段打分,挑出十来个高相关的。这一步像面试后的复试,粗筛过了,还得细看。
然后才是生成。大模型读着这些片段,合成一段答案。关键是 grounding——答案要落在检索到的材料上。好的实现会要求模型标注引用,甚至逐句对应来源。遇到没把握的地方,应该拒答或者提示“公开信息不足”。
但这里有个坑。引用不等于正确。模型可能引了一段,却读歪了。或者把两个来源拼在一起,时间线搞乱。据一些用户反馈,问时效性强的问题时,生成式搜索偶尔会拿旧网页说新事。所以索引刷新频率、元数据里的发布时间,都挺重要。
传统搜索、RAG、Agent 搜索,差在哪
传统搜索给你链接列表,排序靠相关性信号和点击。RAG 更像“检索+生成”的管道,常被问答系统用。生成式AI搜索可以看成 RAG 的搜索产品化版本,多了查询理解、重排、引用、评估这些环节。
Agent 搜索又不一样。它会自己决定搜几次、换什么词、要不要点开某个页面。比如先搜“2025 新能源补贴”,发现政策变了,再搜“过渡期 截止日期”。这种反复检索,延迟更高,成本也更高。不过复杂问题里,它确实能多挖一层。
需要注意的是,生成式AI搜索不是模型把整个互联网背下来了。它没这个记性,也没这个必要。它靠的是实时或近实时的检索,再把碎片拼成话。
想用好它,得留意几个小动作

提问别太省字。把时间、地点、限制条件丢进去,召回会稳不少。比如“北京 周末 亲子 露营 可租装备”比“推荐露营”强。
看到答案先扫引用。引用来源是不是可靠?发布时间是不是新的?如果答案里数字很具体,但引用点不进去,或者点进去对不上,那就得多留个心眼。
还有,权限过滤要前置。企业搜索里,如果先检索再过滤,可能把不该看的片段喂给模型。正确做法通常是在检索阶段就带权限条件,别等生成完再删。
缓存和成本也绕不开。每次查询都跑大模型,钱包会疼。常见做法是缓存高频答案、用小模型做重排、把简单查询路由到传统搜索。说实话,不是每个问题都值得动用完整 RAG 管道。
你在用这类搜索时,更烦它编答案,还是更烦它给一堆链接?欢迎结合具体场景继续聊。
